Claude Codeでイベントログを使った匿名アンケートを作ってCloudflareに公開する
アンケートを作りたい。回答を集めて、集計もしたい。
Cloudflare には、起きたことを記録していくだけの置き場がある。一度書いたら書き換えず、あとからまとめて数える。3か月経つと古いものから消えていく。アクセスログに近い性質だが、テキストファイルではない。この記事では、そこにアンケートの回答を貯める。
しかも最後には、回答し終わった人に「あなたは〇〇型です」と診断結果を返すところまでやる。そこまでやると、Google フォームでは作れないものになる。
本記事の位置付け
Section titled “本記事の位置付け”データをブラウザの外に置くとき、置き方は3つある(→ Webアプリの2つのタイプ)。この記事はそのうち「集計」を作る。
| 置き方 | どういうことか | 技術 |
|---|---|---|
| 集計 | 集めて数える。1件ずつは取り出さない | Workers Analytics Engine(この記事) |
| 出し入れ | 1件ずつ出し入れする。あとから直す・消すもできる | D1 |
| リアルタイム | その場で見える、その場で決まる | Durable Objects |
アンケートの回答は起きてしまった出来事で、あとから書き換えることがない。全体で何票かが分かればよく、「この人の回答」を1件だけ引くこともない。だから集計で足りる。
レストランに例えるなら、こうなる。
- 冷蔵庫:食材を出し入れする。中身を入れ替える。使えば減る
- 伝票の束(今回):書いたら綴じるだけ。書き換えない。あとで枚数を数える。古い綴りから処分していく
掲示板の投稿はあとから消したり直したりするので冷蔵庫が要る。アンケートは伝票で足りる。
作りは Cloudflare Workers(画面もバックエンドも)+ Workers Analytics Engine(データの置き場)。D1でデータ共有型Webアプリを作るを先にやった人は、置き場が D1 から変わっただけと読める。やっていなくても、この記事だけで完結する。
1. 作るもの
Section titled “1. 作るもの”参加者のレベルをざっくり診断するアンケートを作る。仕様はこの4つ。
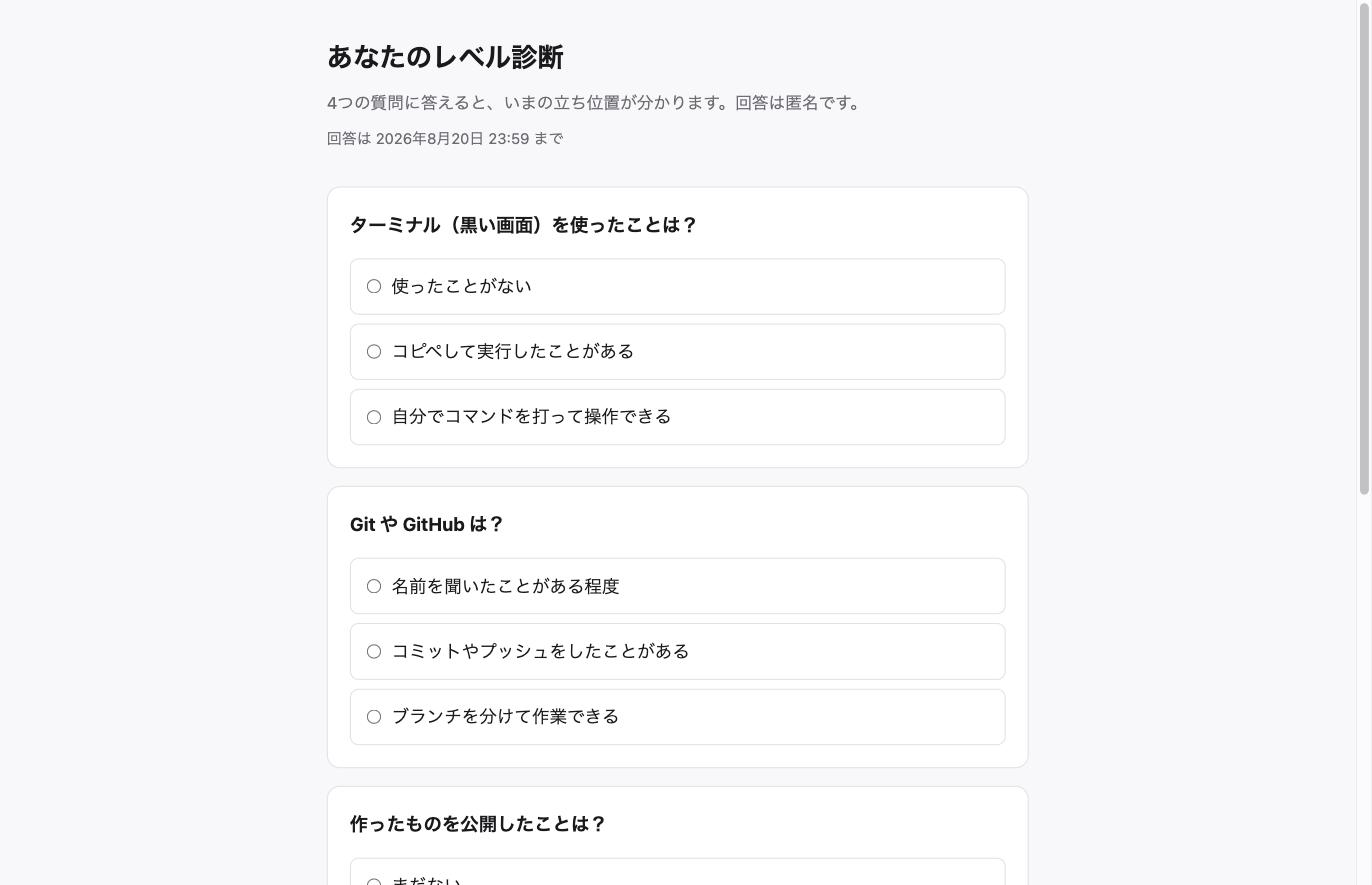
- 選択式の質問に答えると、その場で診断結果が出る
- 同じ人が何度答えても1票として数える
- 締切を過ぎたら受け付けない
- 主催者だけが集計を見られる
完成するとこうなる。
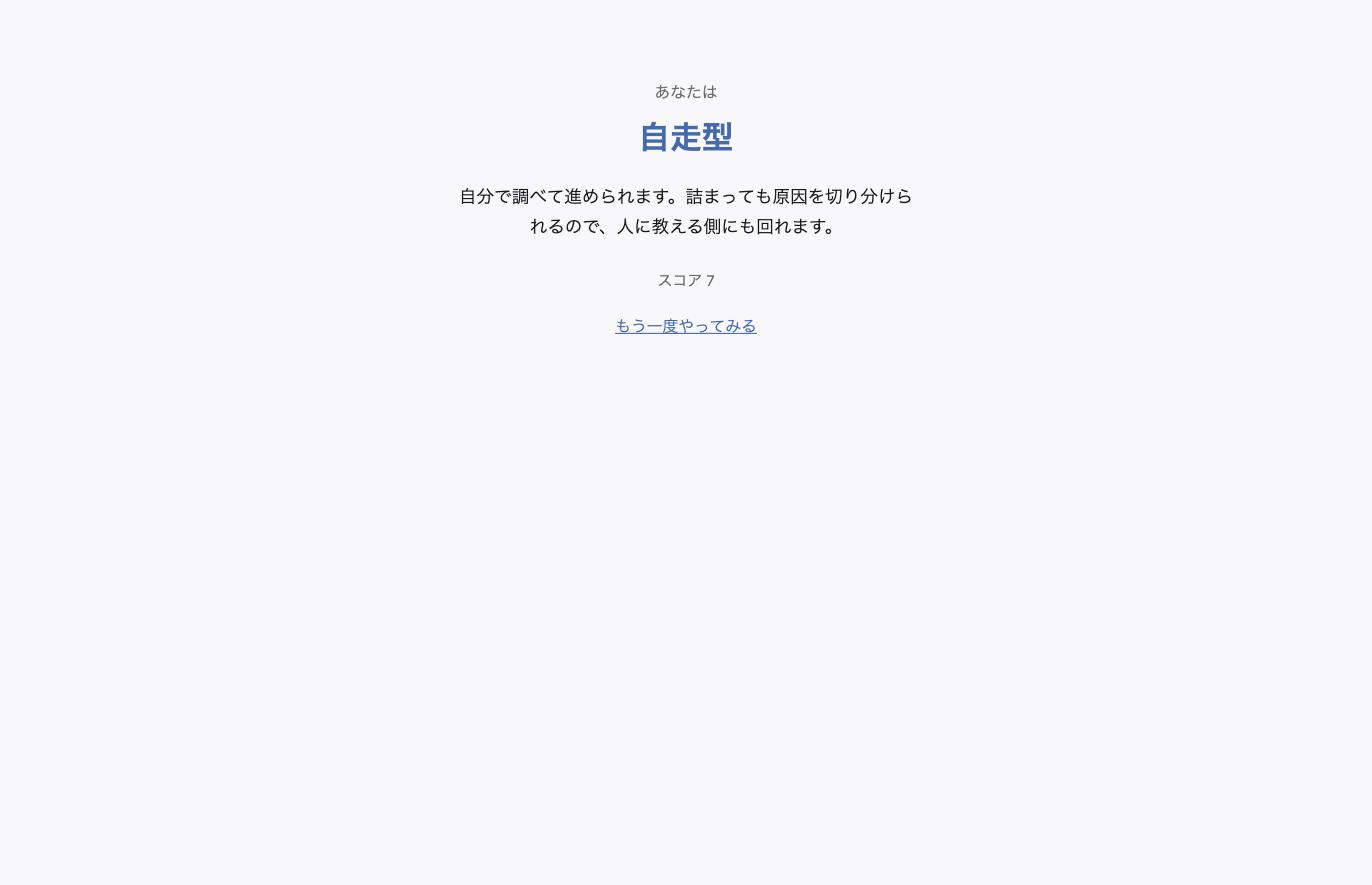
答え終わるとこうなる。
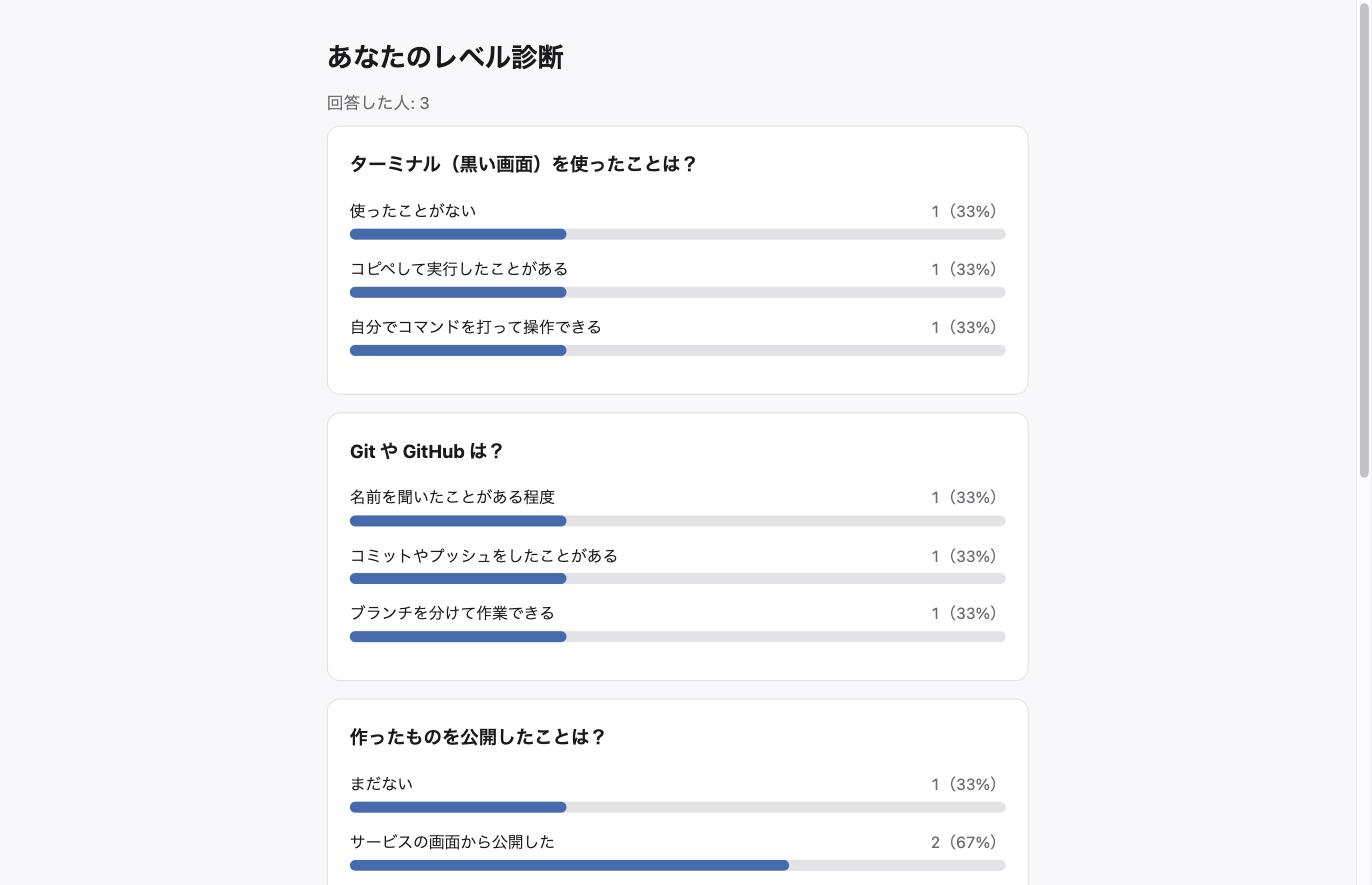
主催者はこれを見る。
1-1. テーブルを作らずに、SQL で数える
Section titled “1-1. テーブルを作らずに、SQL で数える”回答を貯める先は Workers Analytics Engine という。名前のとおり分析用のもので、起きたことを1件ずつ記録していく使い方をする。
ただし「ログ」と聞いて思い浮かべるテキストファイルではない。表の形で貯まっていて、grep ではなく SQL で集計できる。それでいて、「テーブルを作る」「列の型を決める」という準備がまったく要らない。
SQL:貯まったデータに対して「どの条件のものを、どう数えるか」を指示する言い方。データを扱う世界の共通語で、この記事では Claude に「集計して」と頼めば SQL を書いて実行してくれる。自分で書けなくてよい。
イメージとしては、かなり変わったエクセルを思い浮かべるといい。
- 行を足すことしかできない。 1人が1問答えるごとに1行増えていく
- 一度入れたセルは書き換えられない。 修正も削除もできない
- 列は最初から43個あって、増やせない。 使わない列は空のまま
- 見出し行がない。 「この列は質問ID」と書いておく場所がない
- 3か月経った行から消えていく
ずいぶん不便に見えるが、そのぶん設計する作業がゼロになる。テーブルを作らなくていい。列の型を決めなくていい。ファイルを用意することすら要らず、最初に書き込んだ瞬間にできる。
そして、この表に SQL をかけて集計できる。「テーブル設計はしないが SQL で集計できる」という、少し不思議な立ち位置になっている。
43個の列は、3つの種類に分かれている。
| 種類 | 中身 | 今回入れるもの |
|---|---|---|
blobs | 文字列(20個) | アンケートID・質問ID・選択肢ID・回答者ID |
doubles | 数値(20個) | 使わない |
indexes | 特別な1個 | アンケートID+質問ID |
アンケートIDを一緒に入れておく。 この表は消せないので、次にアンケートを取るときも同じ表に追記されていく。IDを持たせておけば、集計のときに「今回の分だけ」を取り出せる。入れ忘れると、次のアンケートで前回の回答と混ざる。
indexes だけ毛色が違う。これはデータが大量になったときに、全部ではなく一部だけを読んで全体を推定するための単位。指定は必須なので何かを入れることになる。
もうひとつ大事な考え方がある。重複回答の排除を、書き込むときではなく集計するときにやる。
先に調べてから書くやり方なら、「この人はもう答えたか」を確認してから書き込む。そのために誰が答えたかを覚えておく必要があり、つまり状態を持つことになる。今回は何も調べずに書き込んで、数えるときに同じ人の回答をまとめる。集計の SQL を1行変えるだけなので、状態を持たなくていい。
1-2. お金はかかるのか
Section titled “1-2. お金はかかるのか”かからない。今回使うものは、すべて Cloudflare の無料の範囲で動く。
Workers Analytics Engine の無料枠はこうなっている。
| 無料枠 | アンケートに直すと | |
|---|---|---|
| 書き込み | 1日10万件 | 5問のアンケートなら1日2万人ぶんの回答 |
| 集計(読み出し) | 1日1万回 | 結果ページを1日5000回開ける |
数えるのは行の数。今回は質問1つにつき1行書く作りにしているので(理由は5章)、5問のアンケートに1人が答えると5行になる。つまり「回答した人数 × 質問数」。1日2万人が答えても届かない計算になる。
さらに公式ドキュメントには、現時点では Analytics Engine の利用料を請求していないと書かれている(Pricing)。将来課金する前提の書き方なので「ずっと無料」という約束ではないが、少なくとも今は無料枠を気にする必要すらない。
ページを置く Cloudflare Workers も、個人が使う範囲なら無料で足りる。静的ファイルの配信は無料・無制限で、リクエスト数に数えられるのは /api/vote のようにコードを呼んだときだけ(Billing and Limitations)。
1-3. データベースでも作れる。それでもこちらを選ぶ理由
Section titled “1-3. データベースでも作れる。それでもこちらを選ぶ理由”同じアンケートは D1(データベース)でも作れる。テーブルを1つ用意して、回答を1行ずつ入れて、GROUP BY で数えればいい。そちらのほうが素直なくらいで、「この回答を消す」「あとから直す」といった操作もできる。
それでもイベントログを選ぶ理由が2つある。
1つ目は、準備が要らないこと。 テーブル設計もマイグレーションも無い(→ 1-1)。アンケートは作って配って終わりのものなので、準備の重さがそのまま面倒さになる。
2つ目は、数の制限。 D1 は無料プランだと10個までしか作れない。
| 無料プランの上限 | |
|---|---|
| D1 データベース | 10個(有料プランなら 50,000個) |
| イベントログのデータセット | 上限の記載なし |
10個は、試しているうちに意外と早く当たる。動いているアプリのぶんは消せないので、そのときは有料プランに上げるか、どれかを消すことになる。
イベントログはそもそも1つのデータセットを使い回す作りにできる(アンケートごとにIDで分ける。→ 10-3)ので、アンケートを何回取っても増えない。別のサイトで並行して取るなど、分けたくなったときは増やせばいい(データセットの数には上限が書かれていないので、そこで詰まらない)。
どちらが上、という話ではない。 1件ずつ読んだり直したりするならデータベースが要る(→ Webアプリの2つのタイプ)。アンケートは集めて数えるだけなので、軽いほうで足りる。
2. 事前準備
Section titled “2. 事前準備”WranglerでCloudflareに公開するまでを済ませていること。wrangler が使えて、Cloudflare にログインできていればいい。
2-1. ベース名を決める
Section titled “2-1. ベース名を決める”このアプリでは、作業フォルダ・Worker・Analytics Engine のデータセットに名前を付ける。最初に ベース名 を1つ決めて、そこから派生させる。
- 例:
my-survey、survey-yto(イニシャル)、survey-0819(日付)など - 短く・英小文字と数字とハイフンだけにしておく
ベース名はそのまま 公開URL(https://<ベース名>.<アカウントのサブドメイン>.workers.dev)の先頭になる。アカウントごとのサブドメインの下に置かれるので、他の人と名前がぶつからない。 空いているかどうかを先に調べる必要はない。
この記事では、決めたベース名を <ベース名>、データセット名を <データセット> と表記する。ターミナルに直接入力するコマンド例と URL の例は my-survey のまま載せているので、そこは自分のベース名に読み替えてほしい。
2-2. 作業フォルダとエージェントを用意する
Section titled “2-2. 作業フォルダとエージェントを用意する”Finder で作業用のフォルダを新しく作る。たとえば ホーム → claude → my-survey(自分のベース名で)。
次に Claudeデスクトップアプリを起動し、Code(Claude Code)を選択 → 新規 → いま作ったフォルダを指定する。
セッションを開始したら、最初にベース名を覚えさせる。次のプロンプトは、先頭の my-survey(1箇所だけ)を自分のベース名に置き換えて渡す。
このプロジェクトのベース名は my-survey です。これを CLAUDE.md に記録してください。- Worker の名前 = ベース名- Analytics Engine のデータセット名 = ベース名のハイフンをアンダースコアに変えた名前- Analytics Engine の binding 名 = SURVEY(固定)これ以降、私のプロンプトの <ベース名> はベース名に、<データセット> は変換後の名前に読み替えて作業してください。データセット名にハイフンは使えない。 データセット名がそのまま SQL のテーブル名になるため(
my-surveyならmy_survey)。この変換をエージェントに覚えさせておけば、以降は考えなくてよくなる。binding 名を
SURVEYで固定するのは、これがコードから呼ぶときの名前だから。プロジェクトの中だけで使う名前なので、他のアプリと同じでもかまわない。
2-3. 作るものをエージェントに覚えさせる
Section titled “2-3. 作るものをエージェントに覚えさせる”アプリの仕様を、先に CLAUDE.md に書いてしまう。 以降のプロンプトでは「仕様のとおりに」と参照するだけでよくなる。
これから作るアプリの仕様を CLAUDE.md に書いてください。
## 作るもの:匿名アンケート- 選択式の質問に答えると、その場で診断結果が出る- 同じ人が何度答えても1票として数える- 締切を過ぎたら受け付けない- 主催者だけが集計を見られる- 回答はイベントログ(Analytics Engine)に貯める。データベースは使わないなぜ先に書くのか。仕様を毎回のプロンプトに書くと、作りたいものの話と、どう作るかの話が混ざる。先に1回書いておけば、以降のプロンプトは「どう作るか」だけになる。自分のアンケートを作るときは、ここを差し替えるだけでよい。
2-4. Analytics Engine を有効にする
Section titled “2-4. Analytics Engine を有効にする”ここを飛ばすと、あとのデプロイが必ず失敗する。 しかも失敗の仕方が分かりにくいので、先にやっておく。
Cloudflare のダッシュボードで Storage & databases から Analytics Engine を開き、右上の Enable を押す。
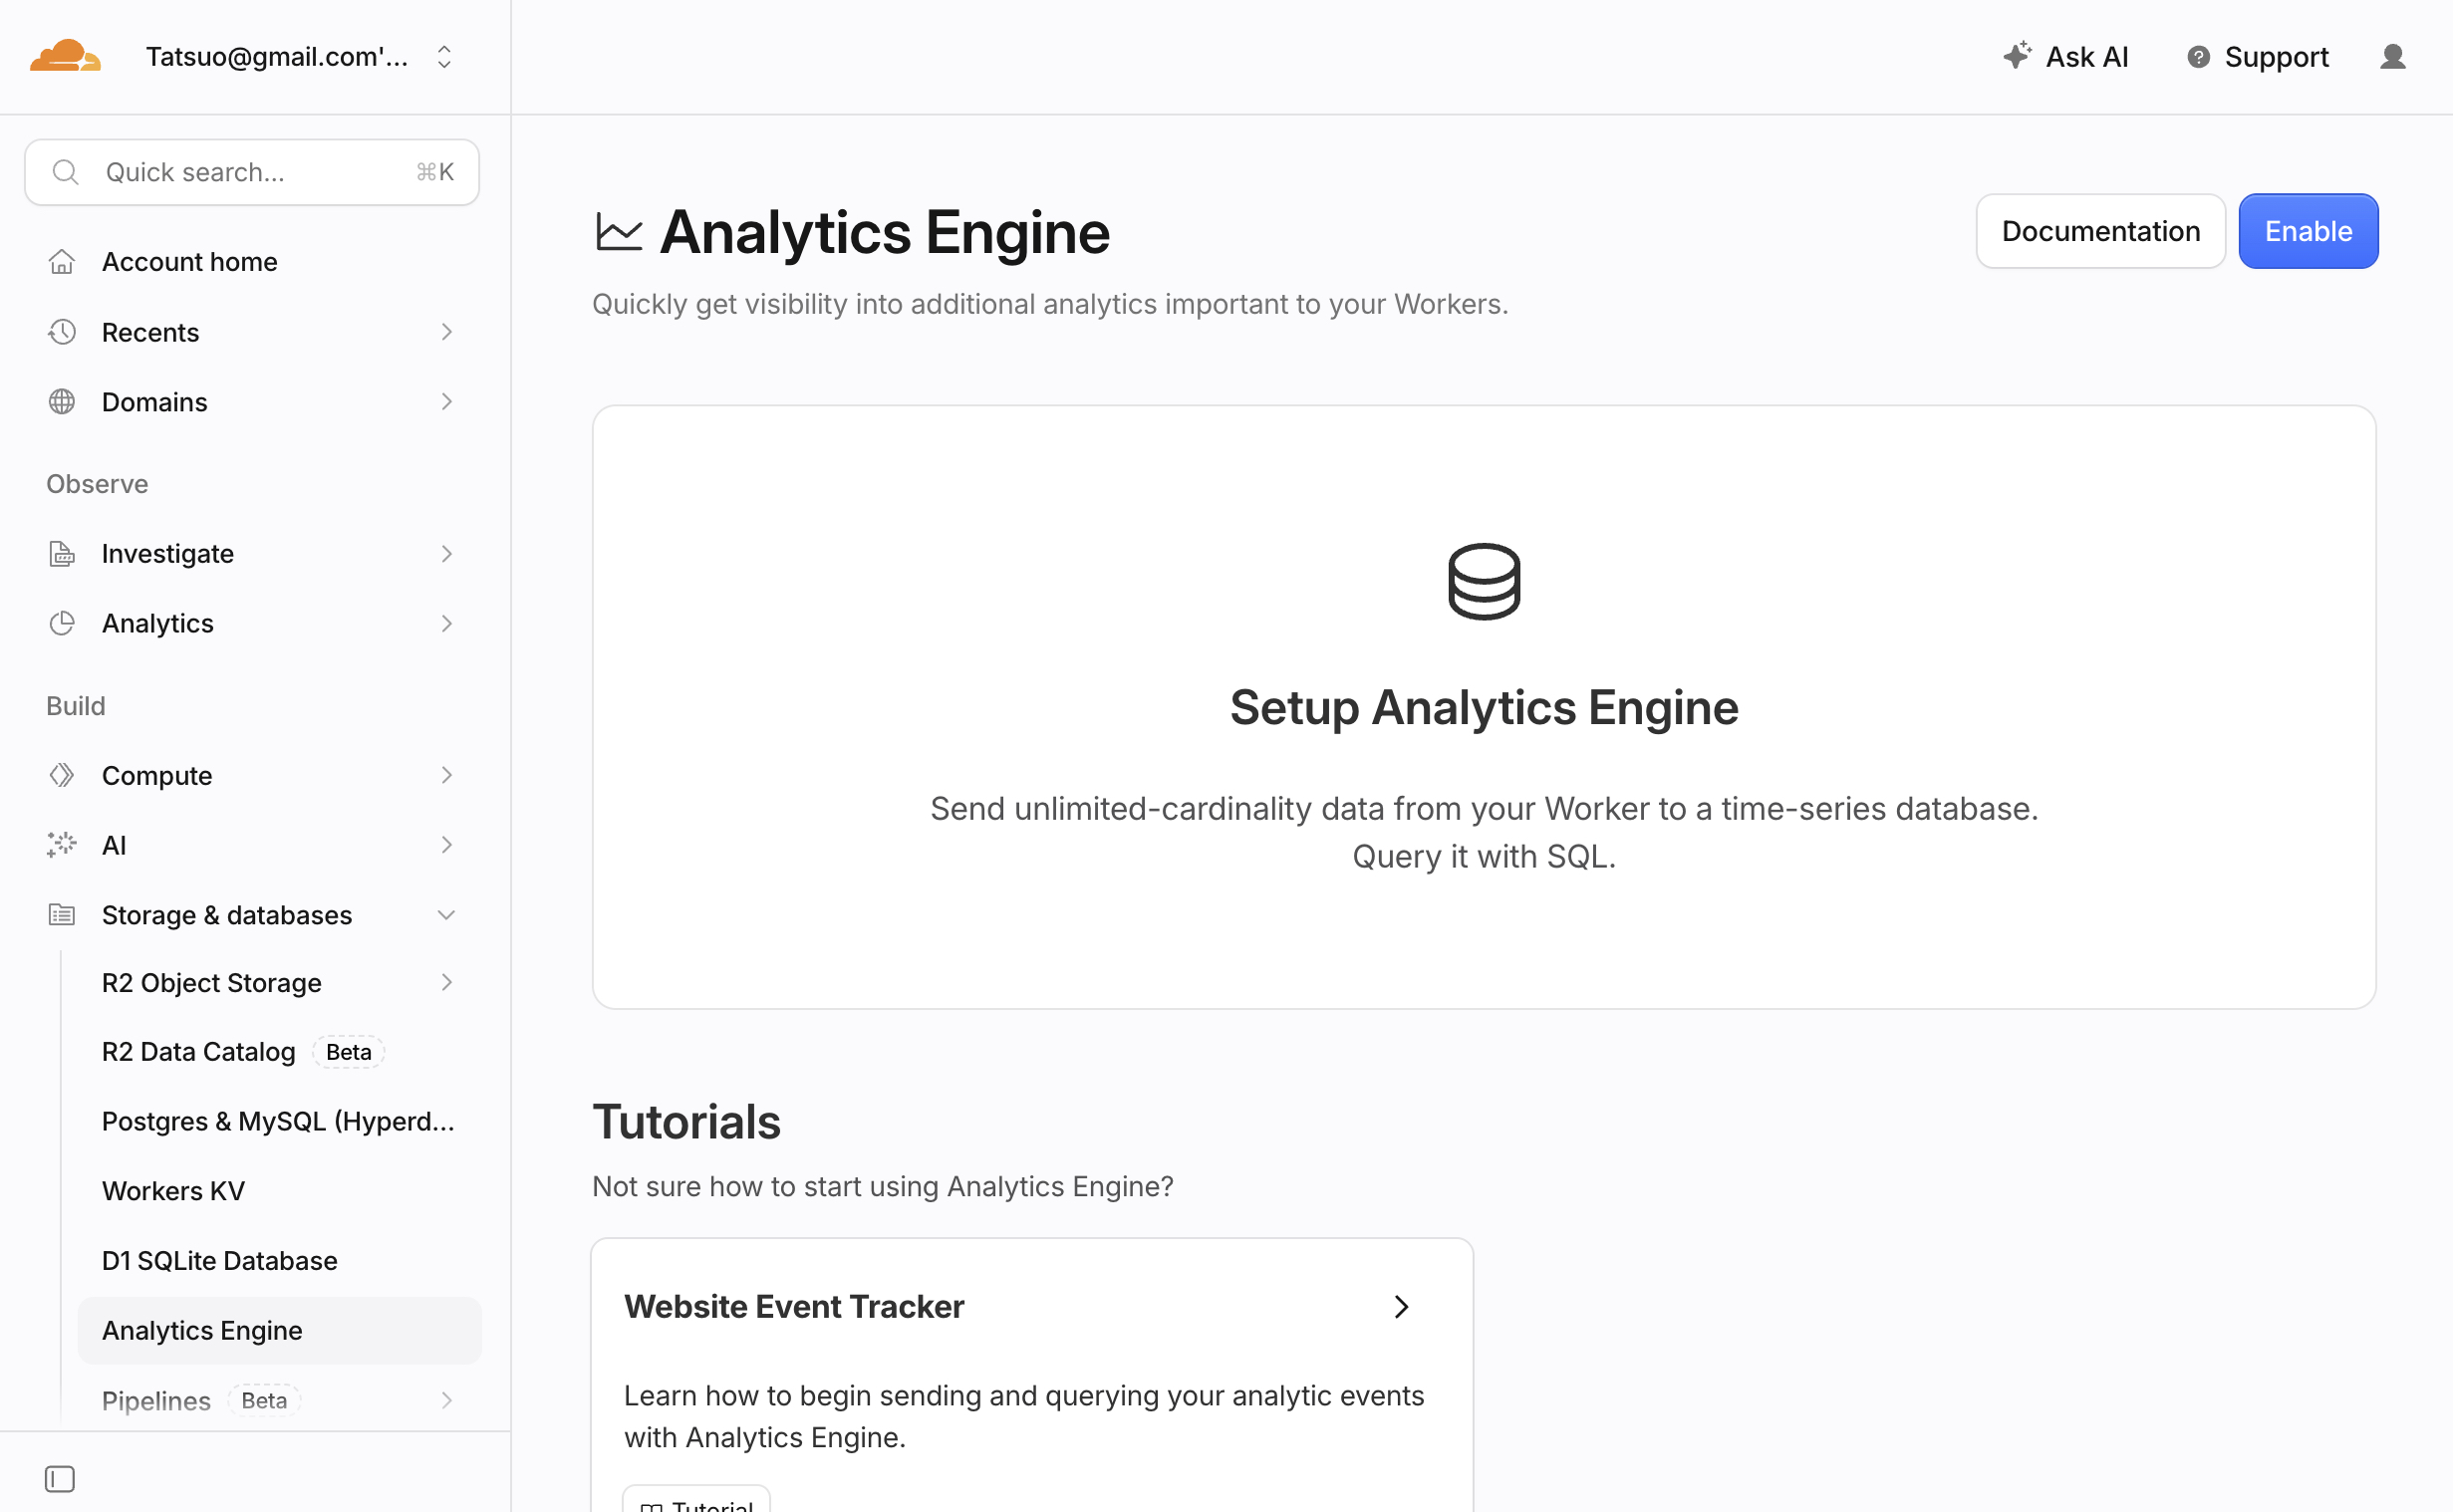
押すとボタンの位置が Create Dataset に変わる。作業はこれだけ。
隣に Create Dataset があるので押したくなるが、押さなくていい。データを入れる箱(データセット)は、最初に書き込んだ瞬間に自動で作られる。名前はあとで設定ファイルに書くので、ここで決める必要もない。
2-5. Wrangler が使えるか確認する
Section titled “2-5. Wrangler が使えるか確認する”npx wrangler whoamiアカウント名やメールアドレスが表示されればOK。表示されない場合はWranglerハンズオンの1章を参照してインストール・ログインする。
3. アンケートのページを作る
Section titled “3. アンケートのページを作る”まずは画面から作る。この段階ではまだ Cloudflare は関係ない。 ブラウザで開けば動く HTML ファイルを1枚作るだけ。
この画面は、まだどこにも送らない。 送信先(受け口)は5章で作って、そこでつなぐ。
D1のハンズオンとは順序が違う。 あちらは全部作ってから公開するが、こちらは先に公開してから中身を作る。イベントログは手元で動かせず、公開しないと書き込みを試せないため。だから画面 → 公開 → 受け口、の順になる。
3-1. 質問をファイルにまとめる
Section titled “3-1. 質問をファイルにまとめる”質問と選択肢を、先に1つのファイルにまとめておく。あとで差し替えられるようにするため。
survey.md を作って。中身はこれ。
# あなたのレベル診断
## ターミナル(黒い画面)を使ったことは?- 使ったことがない- コピペして実行したことがある- 自分でコマンドを打って操作できる
## Git や GitHub は?- 名前を聞いたことがある程度- コミットやプッシュをしたことがある- ブランチを分けて作業できる
## 作ったものを公開したことは?- まだない- サービスの画面から公開した- コマンドでデプロイした
## エラーが出たときは?- どうしていいか分からなくなる- エラー文を検索したり AI に聞く- ログを読んで原因を絞り込める選択肢は経験が浅い順に並べている。あとで診断(9章)を作るとき、この順番がそのまま点数になる。
なぜ別ファイルにするのか。質問は回ごとに変わるが、アプリの作りは変わらない。分けておけば、次のアンケートはこのファイルを書き換えて作り直すだけでよい(→ 10-3)。前回の質問を
survey-2026-08.mdのように残しておくこともできる。
CLAUDE.md(2-3 の仕様)に書かないのは、寿命が違うから。仕様は変わらないが、質問は毎回変わる。
3-2. ページを作る
Section titled “3-2. ページを作る”survey.md を読んで、アンケートのページを作って。public/index.html に置いてほしい。
- 質問と選択肢は HTML の中に JSON で埋め込む。実行時に survey.md を読みに行かない- ラジオボタンで選んで送信ボタンを押す形- 送信ボタンを押したら、選んだ内容を画面に出すだけでよい(送信先はあとで決める)- ファイルをダブルクリックで開いても表示と選択の確認ができるようにする途中でファイル操作の許可を求められたら、その都度許可する。
「実行時に読みに行かない」は必ず書く。 ここを落とすと、エージェントが
survey.mdを読み込むコードを書くことがある。そうするとファイルをダブルクリックしても動かなくなる(file:で開いたページからの読み込みはブラウザが拒否するため)。埋め込むのは作るときの1回だけ、と伝える。
できあがった JSON には、質問と選択肢それぞれに id が振られている。この id はあとから変えられない。 集計はこの id でまとめるので、回答を集め始めてから変えると数が合わなくなる。公開する前に質問を決めきっておく、と覚えておけばいい。
できあがったらファイルをダブルクリックして、ブラウザで表示を確認する。見た目が気に入らなければ、この段階で直しておく。まだ公開していないので気楽に試せる。
4. Cloudflare に公開する
Section titled “4. Cloudflare に公開する”設定ファイルの用意からデプロイまでまとめて頼む。2章で有効にした Analytics Engine とのつなぎ込みも、ここで一緒に済ませる。名前は 2-2 で覚えさせたベース名に展開される。
public フォルダを Cloudflare Workers に <ベース名> という名前で公開して。wrangler の設定ファイル(wrangler.jsonc)も作ってほしい。wrangler は npx で呼ぶ。package.json は作らず、インストールもしない。
- 公開ディレクトリは public- Analytics Engine のデータセット <データセット> を SURVEY という名前でバインドする- 環境変数 SURVEY_ID に、このアンケートを表す名前を入れる- compatibility_date は UTC(協定世界時)での今日の日付にする
できあがる wrangler.jsonc はこんな形になる(ベース名を my-survey にした場合)。
{ "name": "my-survey", "compatibility_date": "(YYYY-MM-DD 形式の、UTC での今日の日付)", "assets": { "directory": "./public" }, "vars": { "SURVEY_ID": "level-2026-08" }, "analytics_engine_datasets": [ { "binding": "SURVEY", "dataset": "my_survey" } ]}
compatibility_dateを UTC で指定するのは、日本時間の早朝(0時ごろから9時ごろ)は UTC ではまだ前日だから。その時間帯に日本の「今日」を入れると未来日と判定されて弾かれる。UTC で指定しておけば時間帯に関係なく通る。
analytics_engine_datasets の2行が、さっき有効にした Analytics Engine とつながる部分。binding はコードから呼ぶときの名前、dataset は書き込み先の名前。データセットは事前に用意しなくていい。 ここに名前を書いておけば、最初の回答が届いた時点で自動的に作られる(デプロイした時点ではまだ無い)。
SURVEY_ID は「いま受け付けているアンケートの名前」。 回答と一緒に記録され、集計もこの名前で絞る。次にアンケートを取るときはここを新しくするだけでよく、データセットはそのまま使い回せる(→ 10-3)。最初の1件目から必要なので、後から足すのではなく今のうちに入れておく。
プロジェクト名がハイフン、データセット名がアンダースコアなのは 2-2 のとおり。ベース名から自動で変換される。
裏で動くのはこの2つのコマンド。
npx wrangler deployhttps://my-survey.<アカウントのサブドメイン>.workers.dev で開ける。この URL を配ることになる。
5. 回答を受け取れるようにする
Section titled “5. 回答を受け取れるようにする”ここから Cloudflare 側の処理を作る。といっても、やることは「受け取って書き込む」だけ。
回答を受け取るエンドポイントを Worker で作って。src/index.js に置いて、質問1つにつき1件、Analytics Engine に書き込んでほしい。
- /api/vote への POST だけ受ける。GET は受け付けない- それ以外のリクエストは、public の静的ファイルをそのまま返す- 書き込むのは アンケートID(環境変数 SURVEY_ID)・質問ID・選択肢ID・回答者ID の4つ- indexes には「アンケートID+質問ID」をつないだ値を入れる- 回答者IDは、サーバー側が発行する cookie で見分ける。cookie が無ければ新しく発行する- その cookie は JavaScript から読めないようにして、ページ側には回答者を指す値を一切持たせない- IP アドレスは記録しないできあがるのは、届いた回答を1問ずつ書き込むだけの短いコード。テーブルもスキーマもないので、書き込む前の準備が何も要らない。
wrangler.jsonc にも2つ足される。main がコードの置き場所、assets の binding がコードから静的ファイルを返すための名前。
"main": "src/index.js", "assets": { "directory": "./public", "binding": "ASSETS" },全部のリクエストがコードを通るわけではない。 静的ファイルがあるパス(
/など)はコードを通らずにそのまま返り、ファイルが無いパス(/api/vote)だけがコードに届く。だから画面の表示は4章のときと変わらない。
この4行が、D1 でいうスキーマにあたる。 ただし決定的な違いがある。D1 は「どの列に何を入れるか」をデータベース側が覚えている(あちらの4章で作るマイグレーションがそれ)。イベントログは覚えない。表の側は最後まで「1列目」としか思っていない。
D1のハンズオンでは章がまるごと1つだったものが、ここでは4行に収まっている。「設計する作業がゼロ」というのは、こういうこと。
イベントログは覚えてくれない。 だから、どの値をどこに入れたかを覚えてもらうため CLAUDE.md に残す。
いま決めた「どの値をどこに入れるか」を CLAUDE.md に追記して。集計するときに必要になる。CLAUDE.md にはこんな形で書かれる。
## イベントログの構成- blob1: アンケートID(SURVEY_ID)- blob2: 質問ID- blob3: 選択肢ID- blob4: 回答者ID- indexes: アンケートID+質問IDこれを残さないと、貯めたデータが読めなくなる。 3か月後に「1列目は何だっけ」となったとき、表を見ても分からない(→ 1-1)。6章で集計ページを作るときも、この対応をもとにクエリを書くことになる。
回答者IDの出どころを、必ずプロンプトに書く。 ここを書かずに「回答者ID」とだけ頼むと、エージェントはページ側で作った匿名IDを送ってくる前提で組むことがある。そうすると 5-2 の理由(Safari が消す・期限を決められない・ページから読める)が全部当てはまることになる。どこから来る値なのかまで指定する、と覚えておく。
受け口ができたら、画面をつなぐ。 3章で作ったページは、選択肢を選べるだけでまだどこにも送っていない。
public/index.html の送信ボタンから、さっき作った /api/vote に送るようにして。選んだ選択肢を質問ごとに送って、送り終わったら「ありがとうございました」と画面に出す。ここまでできたらデプロイして、本番URLで実際に答えてみる。
デプロイしてこの時点では、答えられたかどうかしか分からない。 集計を見るための鍵は6章で作る。
5-1. 1人の回答が、質問の数だけ行に分かれる
Section titled “5-1. 1人の回答が、質問の数だけ行に分かれる”書き込みは質問ごとに1回ずつ行われる。だから5問のアンケートに1人が答えると、5行書かれる。次の表はどう入るかのイメージで、実際に中身を見られるのは、集計の鍵を作る6章から。
アンケート 質問 答え 回答者level-2026-08 q1 hard 1a2b3c…level-2026-08 q2 db 1a2b3c…level-2026-08 q3 gui 1a2b3c…どの行にもアンケートIDが入る。 同じ値の繰り返しで無駄に見えるが、この表は消せないので、次のアンケートもこの下に積まれていく。IDが無いと、そのとき前回の回答と区別できない。
1人の回答を1行にまとめることもできる。「1問目の答えは1列目、2問目は2列目」と決めて詰め込めばいい。行数が5分の1になるので、書き込みの数も減る。
それでも分けたのは、集計が楽になるから。
- 質問が何問あっても、同じ SQL で数えられる。 まとめて入れると「1問目を数える」「2問目を数える」とクエリを書き分けることになる
- 列の割り当てを覚えておく必要がない。 「3列目は質問3」という対応表を人間が管理するのは、いつか必ず間違える
- 質問を後から足せる。 まとめて入れる方式だと列は20個までなので、21問目で詰まる
行数と引き換えに、集計の単純さを買っている。書き込みの上限(1日10万行)にはどのみち届かないので、迷わずこちらでいい。
5-2. 同じ人を見分ける
Section titled “5-2. 同じ人を見分ける”同じ人が2回答えたときに2票と数えないために、回答者を見分ける必要がある。ただし名前もメールアドレスも聞かない。サーバーが発行した意味のない文字列を cookie に入れておくだけ。5章のプロンプトで頼んだ、下から2番目と3番目の行がこれにあたる。
ブラウザの localStorage に保存する方法もあるが、今回は cookie にした。理由が3つある。
- 勝手に消えない。 Safari は
localStorageを7日ほど使わないと消してしまう(ログインキーでユーザーアカウント管理でも出てくる話)。アンケートの途中で消えると、同じ人が別人として数えられる。サーバーが発行した cookie はこの削除の対象外 - 期限を決められる。 締切と同時に切れるようにできる(8章)
- ページ側から読めない。 サーバーが発行した cookie は、ページの JavaScript から読めないようにできる(
HttpOnlyという設定)。回答者を指す値がページ側に一切出てこないので、うっかり画面に出したり外部に送ったりする心配がない
6. 集計を見られるようにする
Section titled “6. 集計を見られるようにする”ダッシュボードには、貯めたデータを見る画面が無い。 2-4 で開いた Analytics Engine の画面にあるのは、データセットの一覧と作成ボタンだけ。読み出す方法は API だけで、それにはトークンが要る。
集計するには、Cloudflare の API を呼び出すためのトークンを作ることになる。この記事で唯一、秘密の値を自分の手で扱うところ。
6-1. API トークンを作る
Section titled “6-1. API トークンを作る”右上のアイコンから Profile を開く。
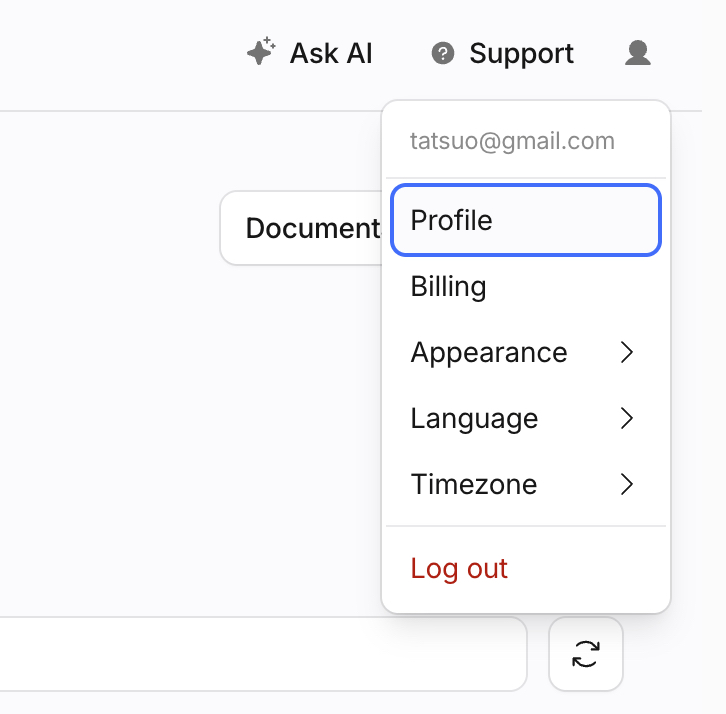
左メニューの API Tokens を開き、右上の Create Token を押す。
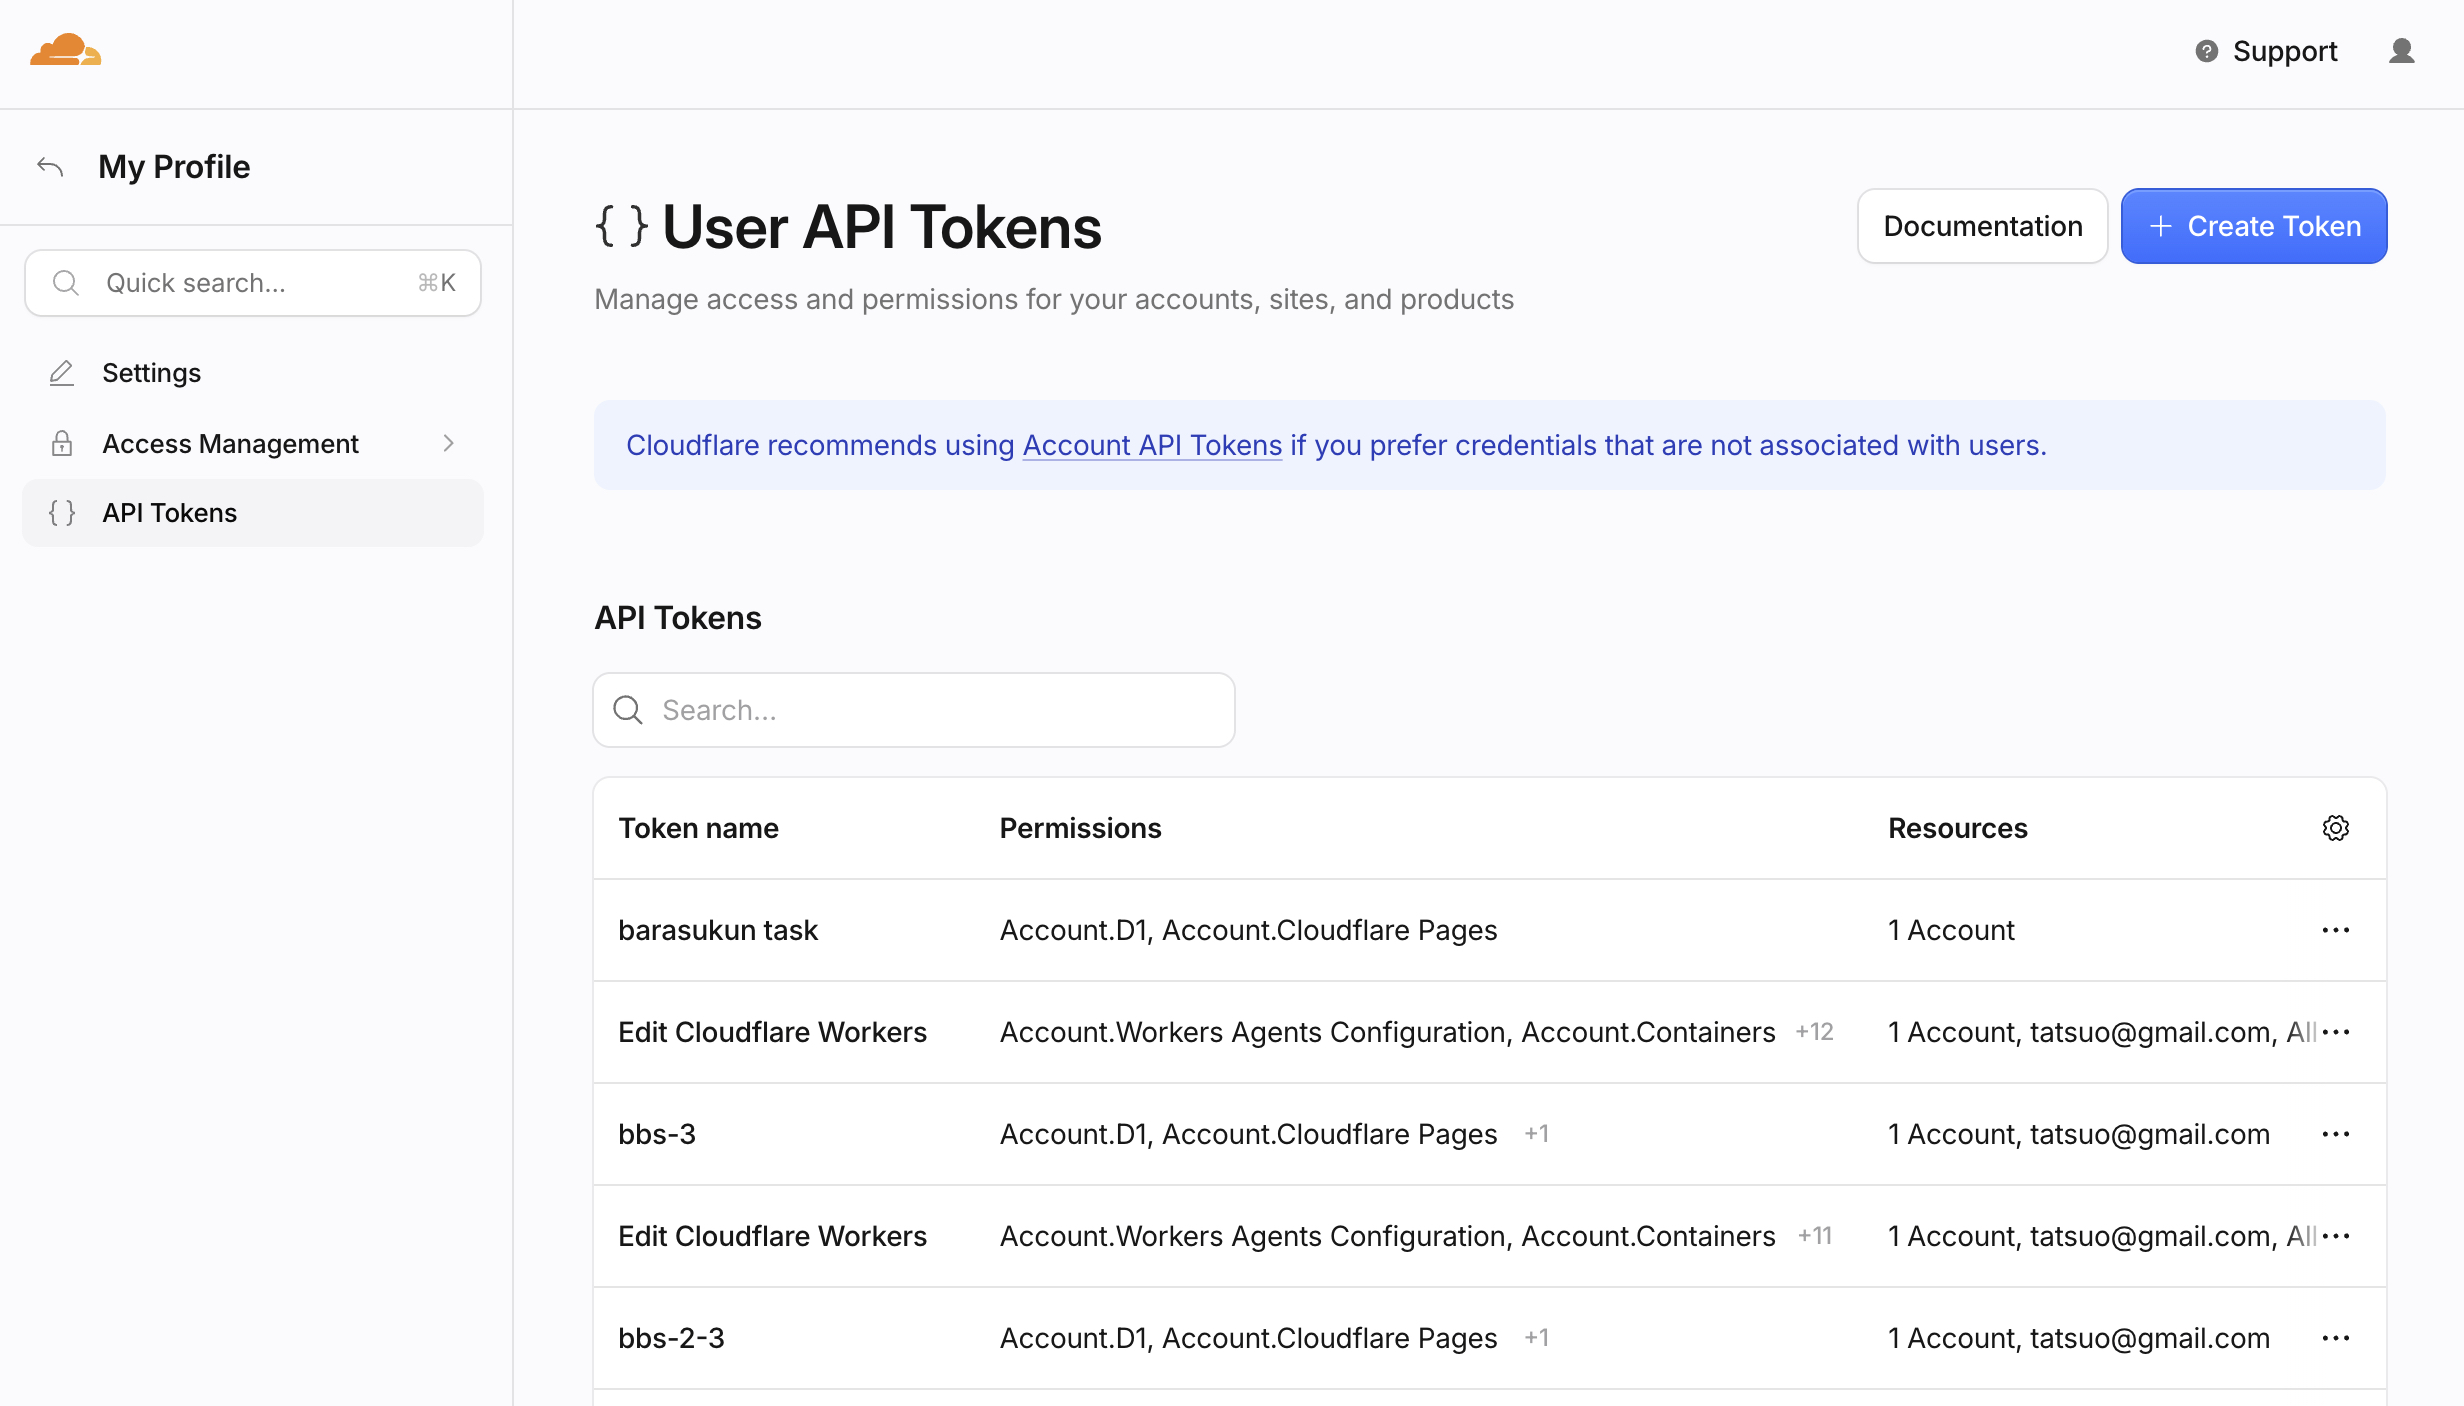
テンプレートがいくつも並んでいるが、使わない。上の方にある Create Custom Token の Get started を押す。
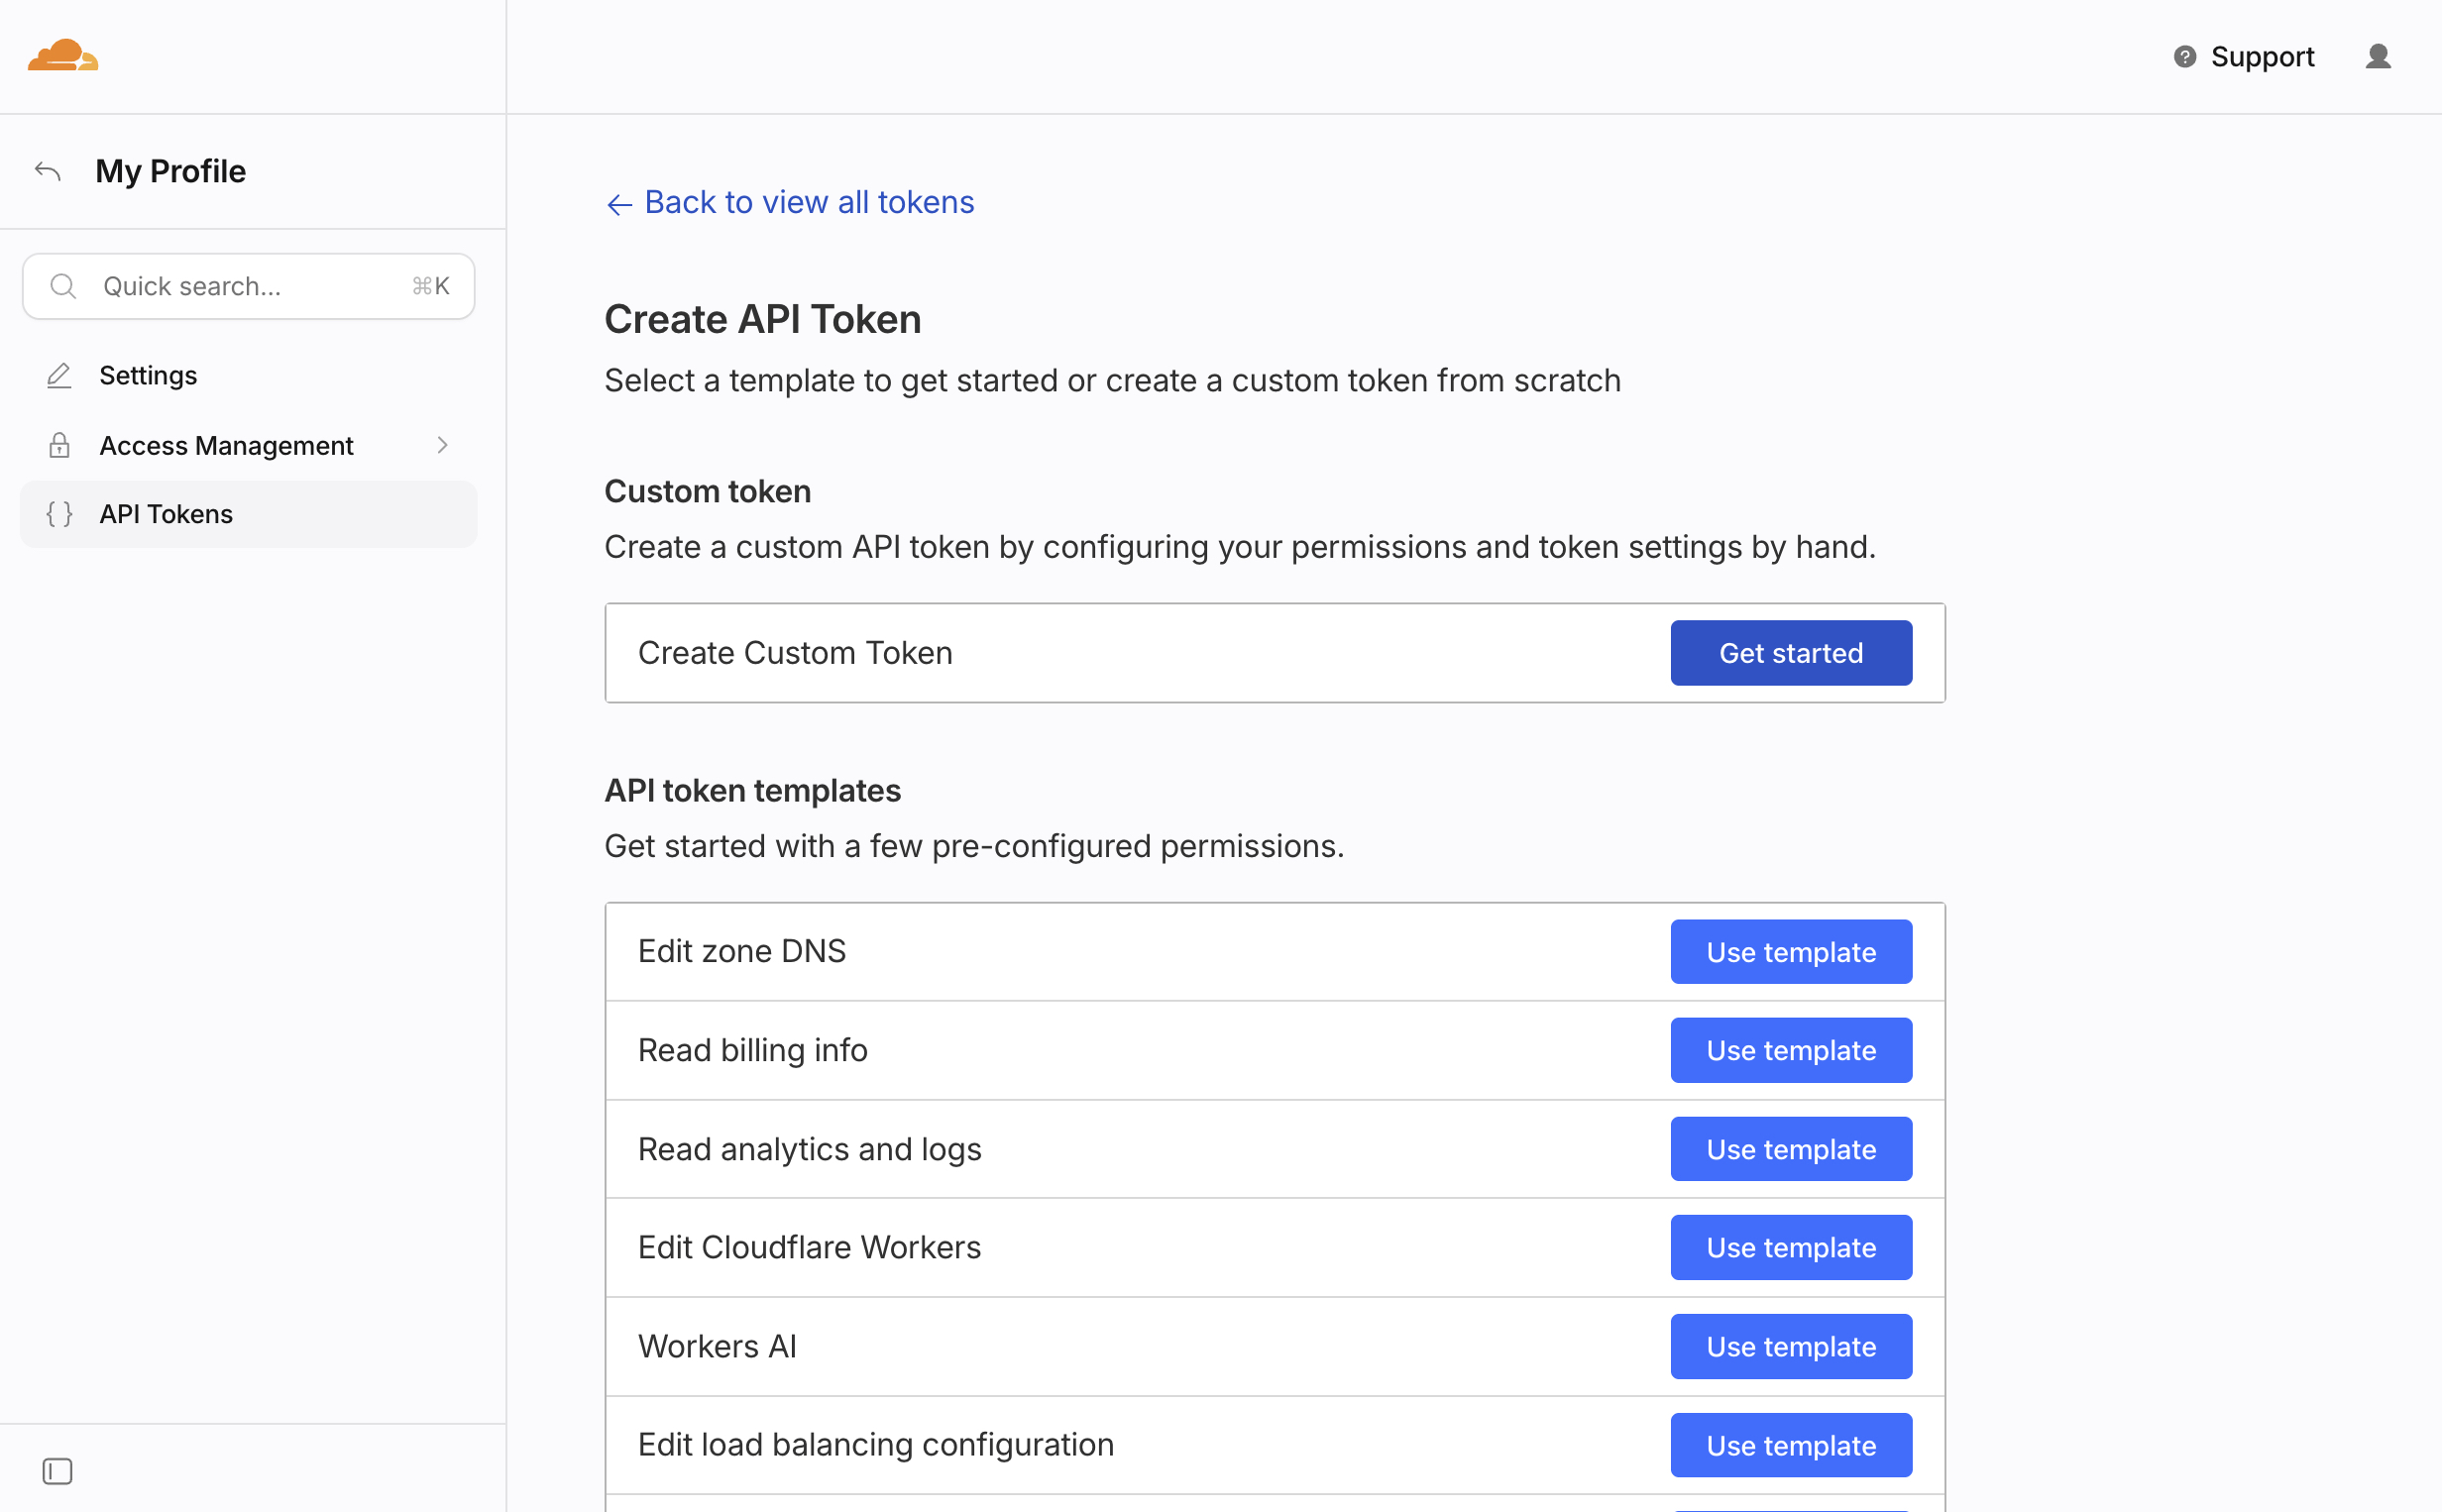
テンプレートには Read analytics and logs という、いかにも今回に合いそうなものがある。それでも自分で作るのは、権限を必要な分だけに絞るため。テンプレートは便利な代わりに、要らない権限まで付いてくることがある。
名前を付けて、Permissions に Account / Account Analytics / Read を指定する。これ1つだけ。 他は何も足さない。Account Resources は自分のアカウントを選ぶ。
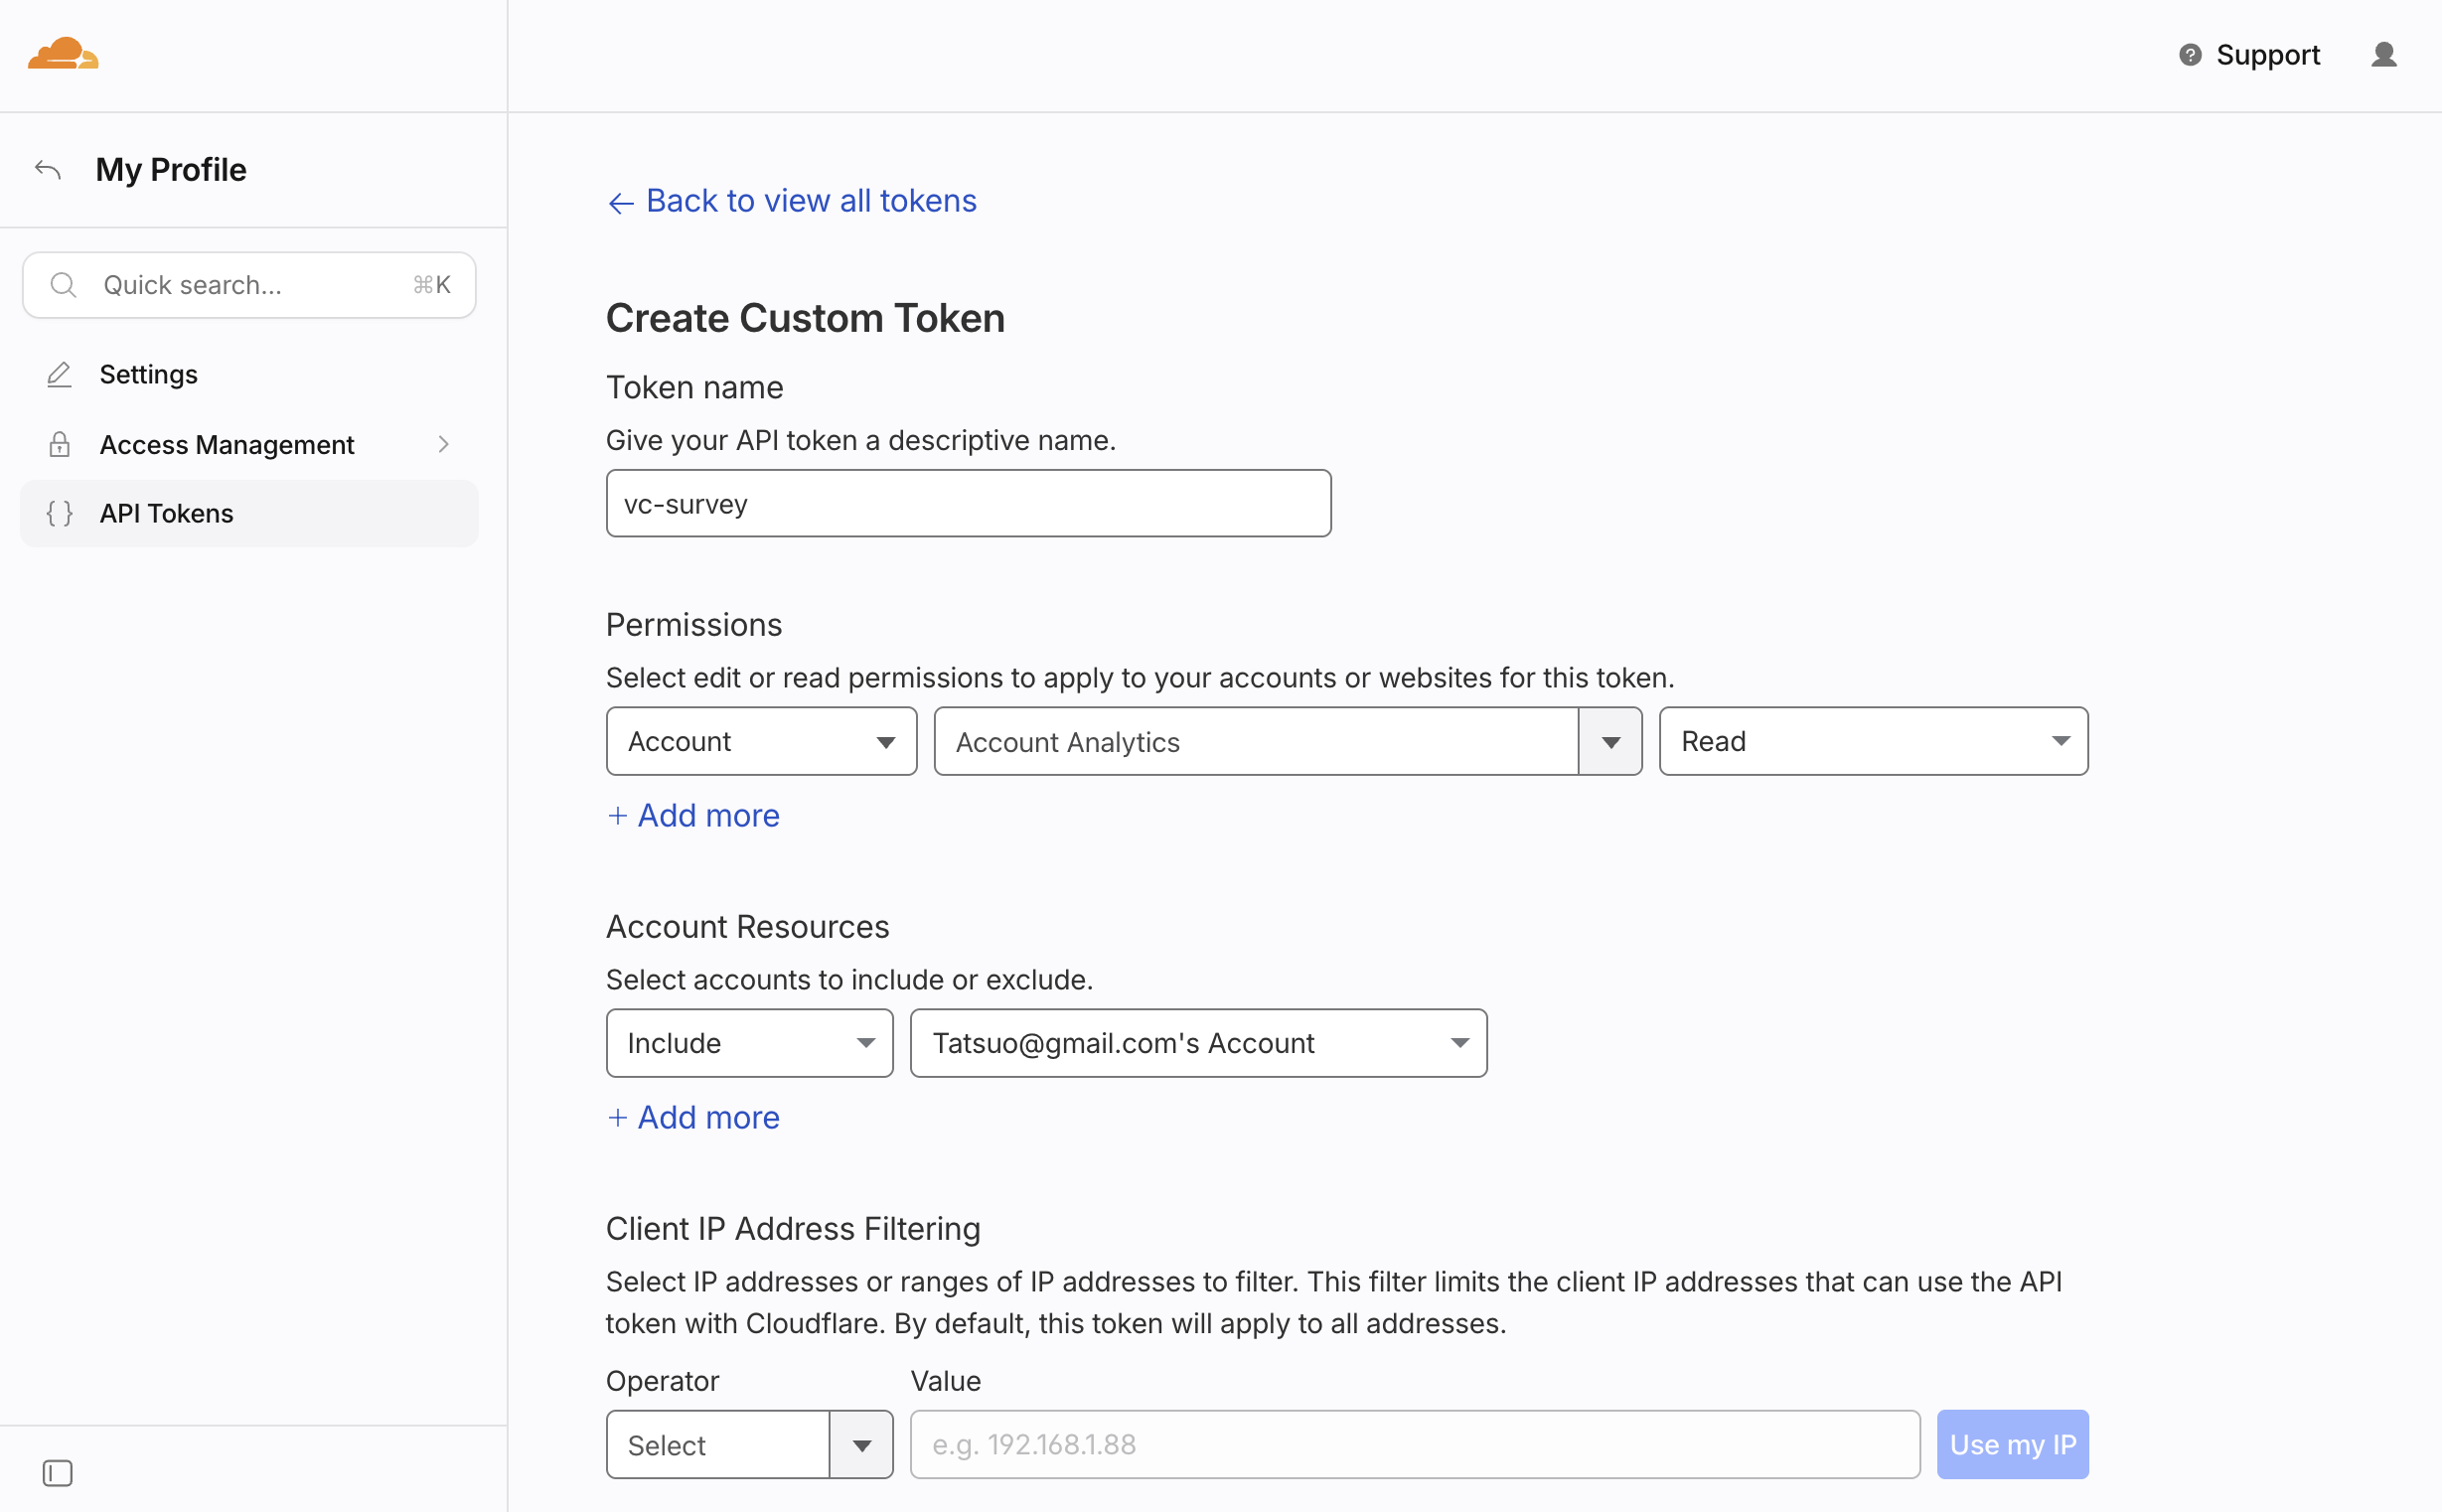
Continue to summary を押すと、与える権限が1行だけ表示される。
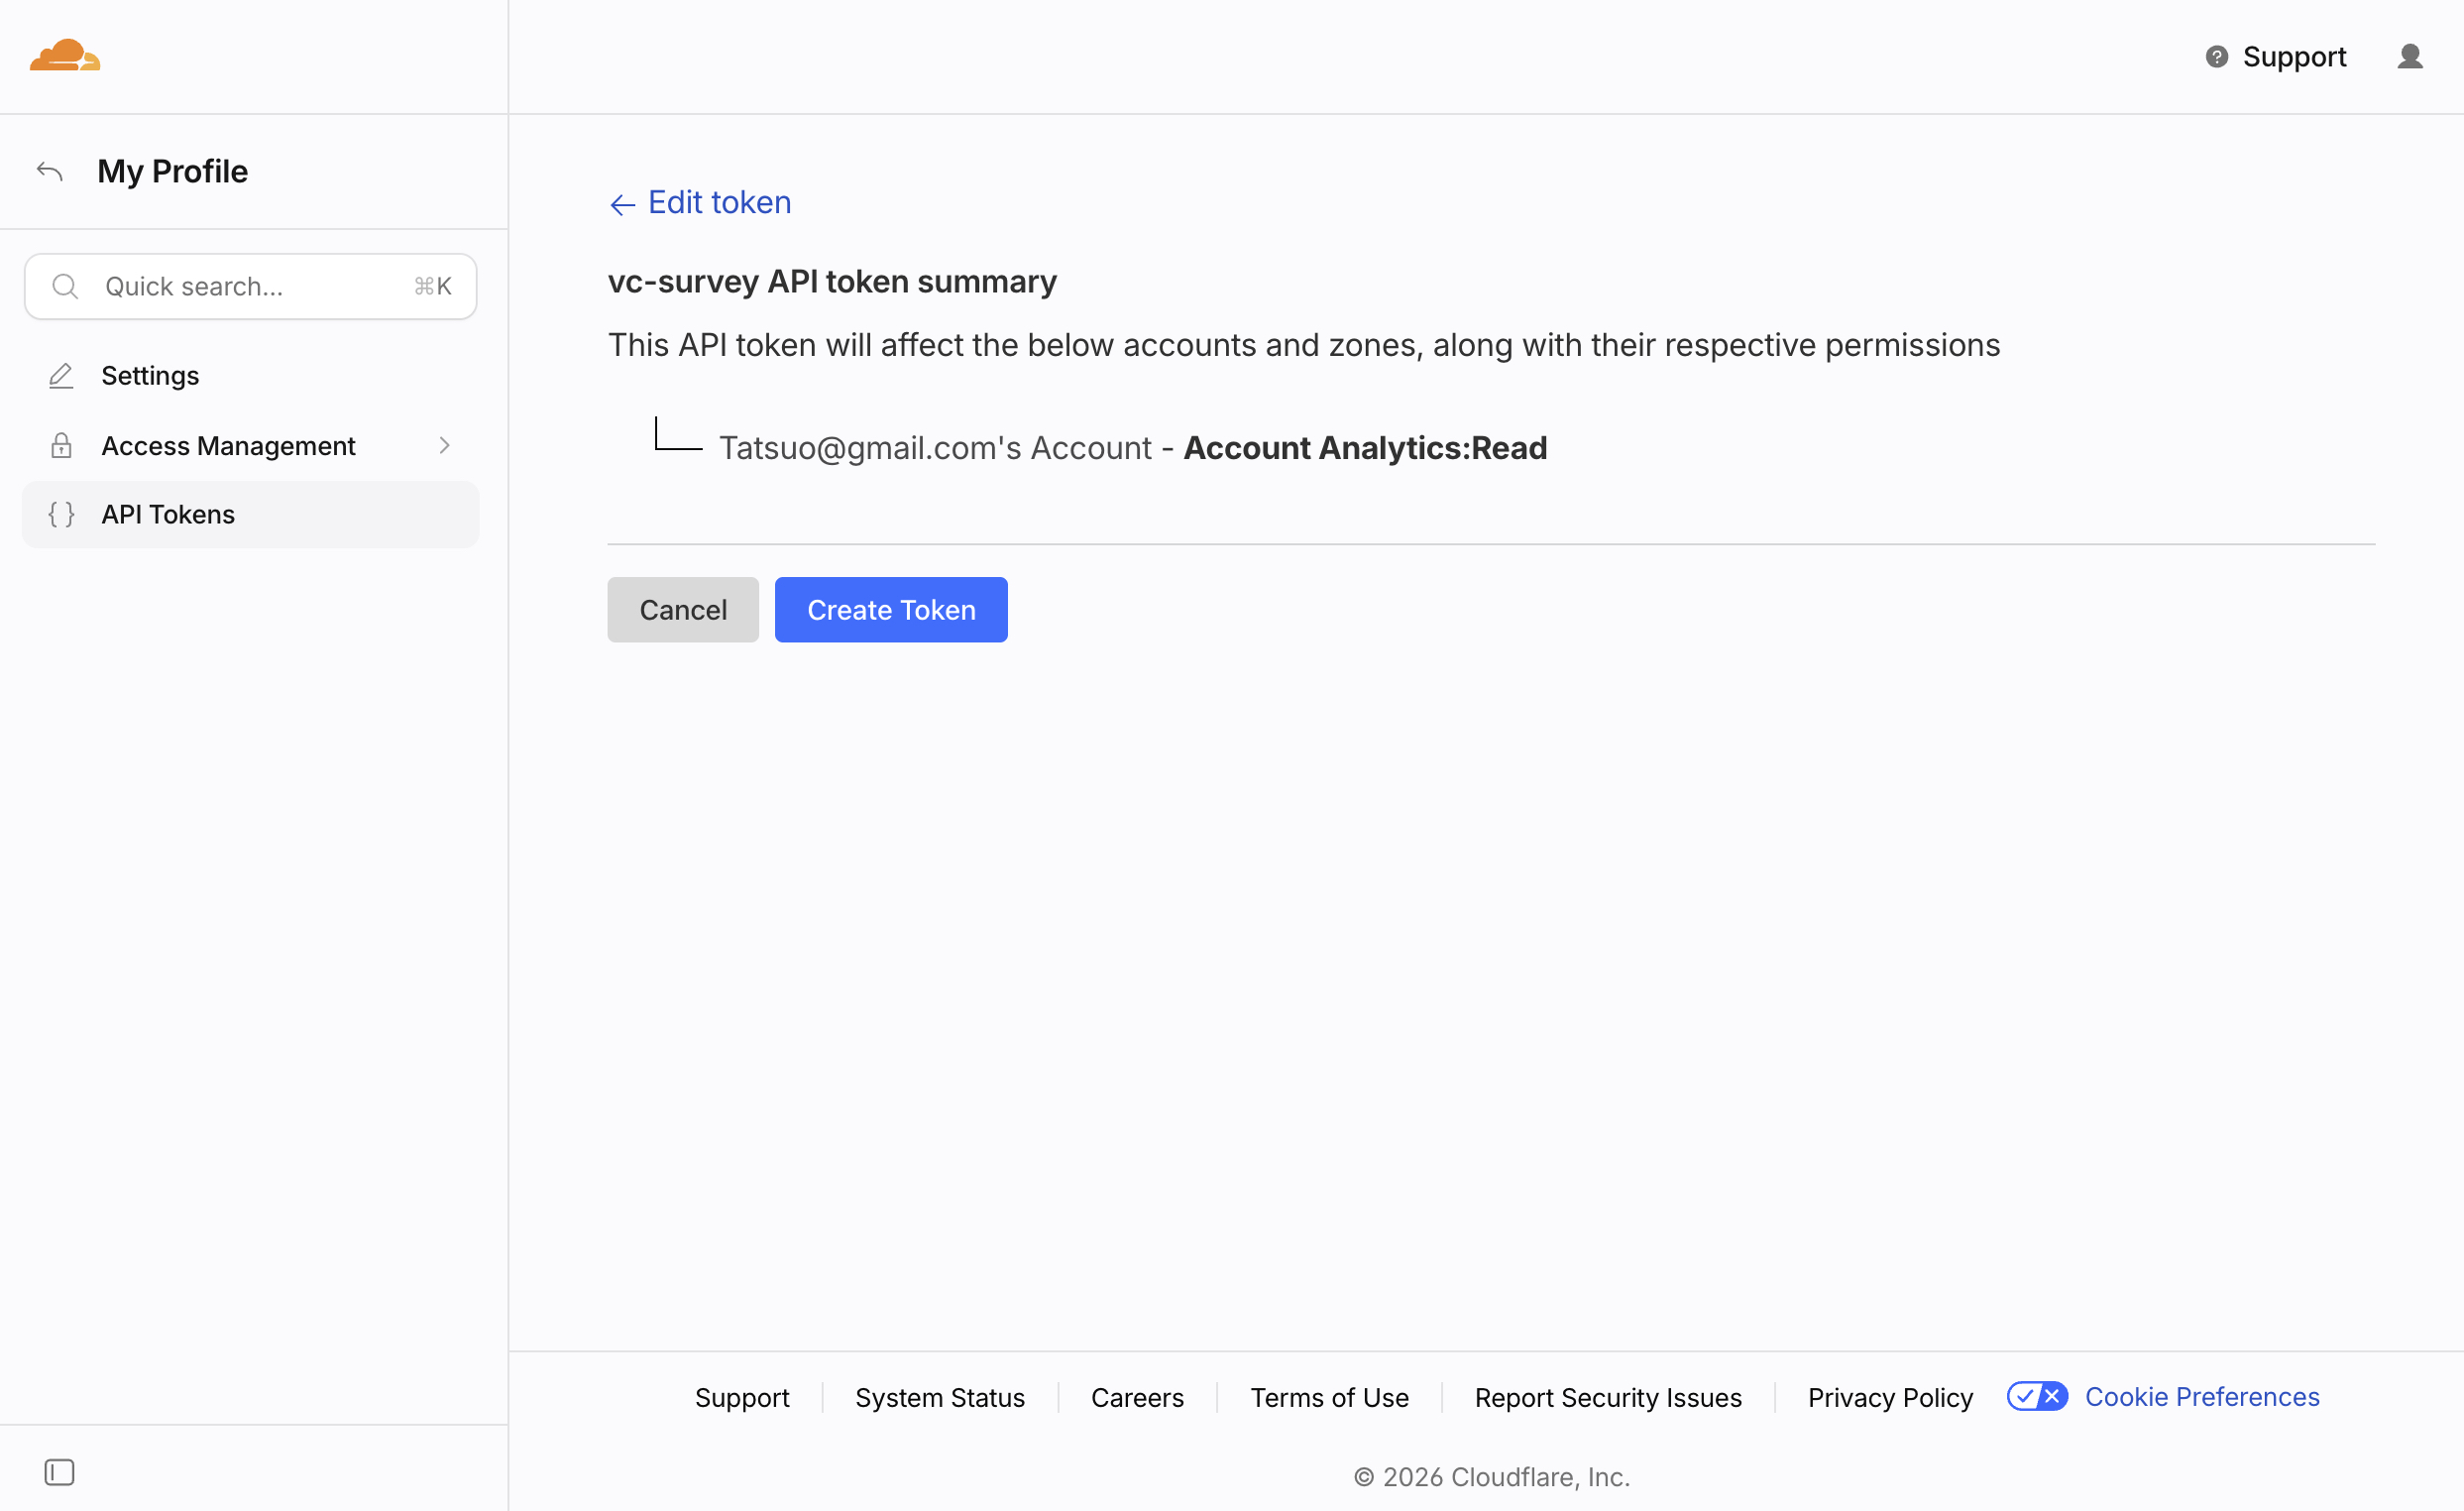
Create Token を押すとトークンが表示される。
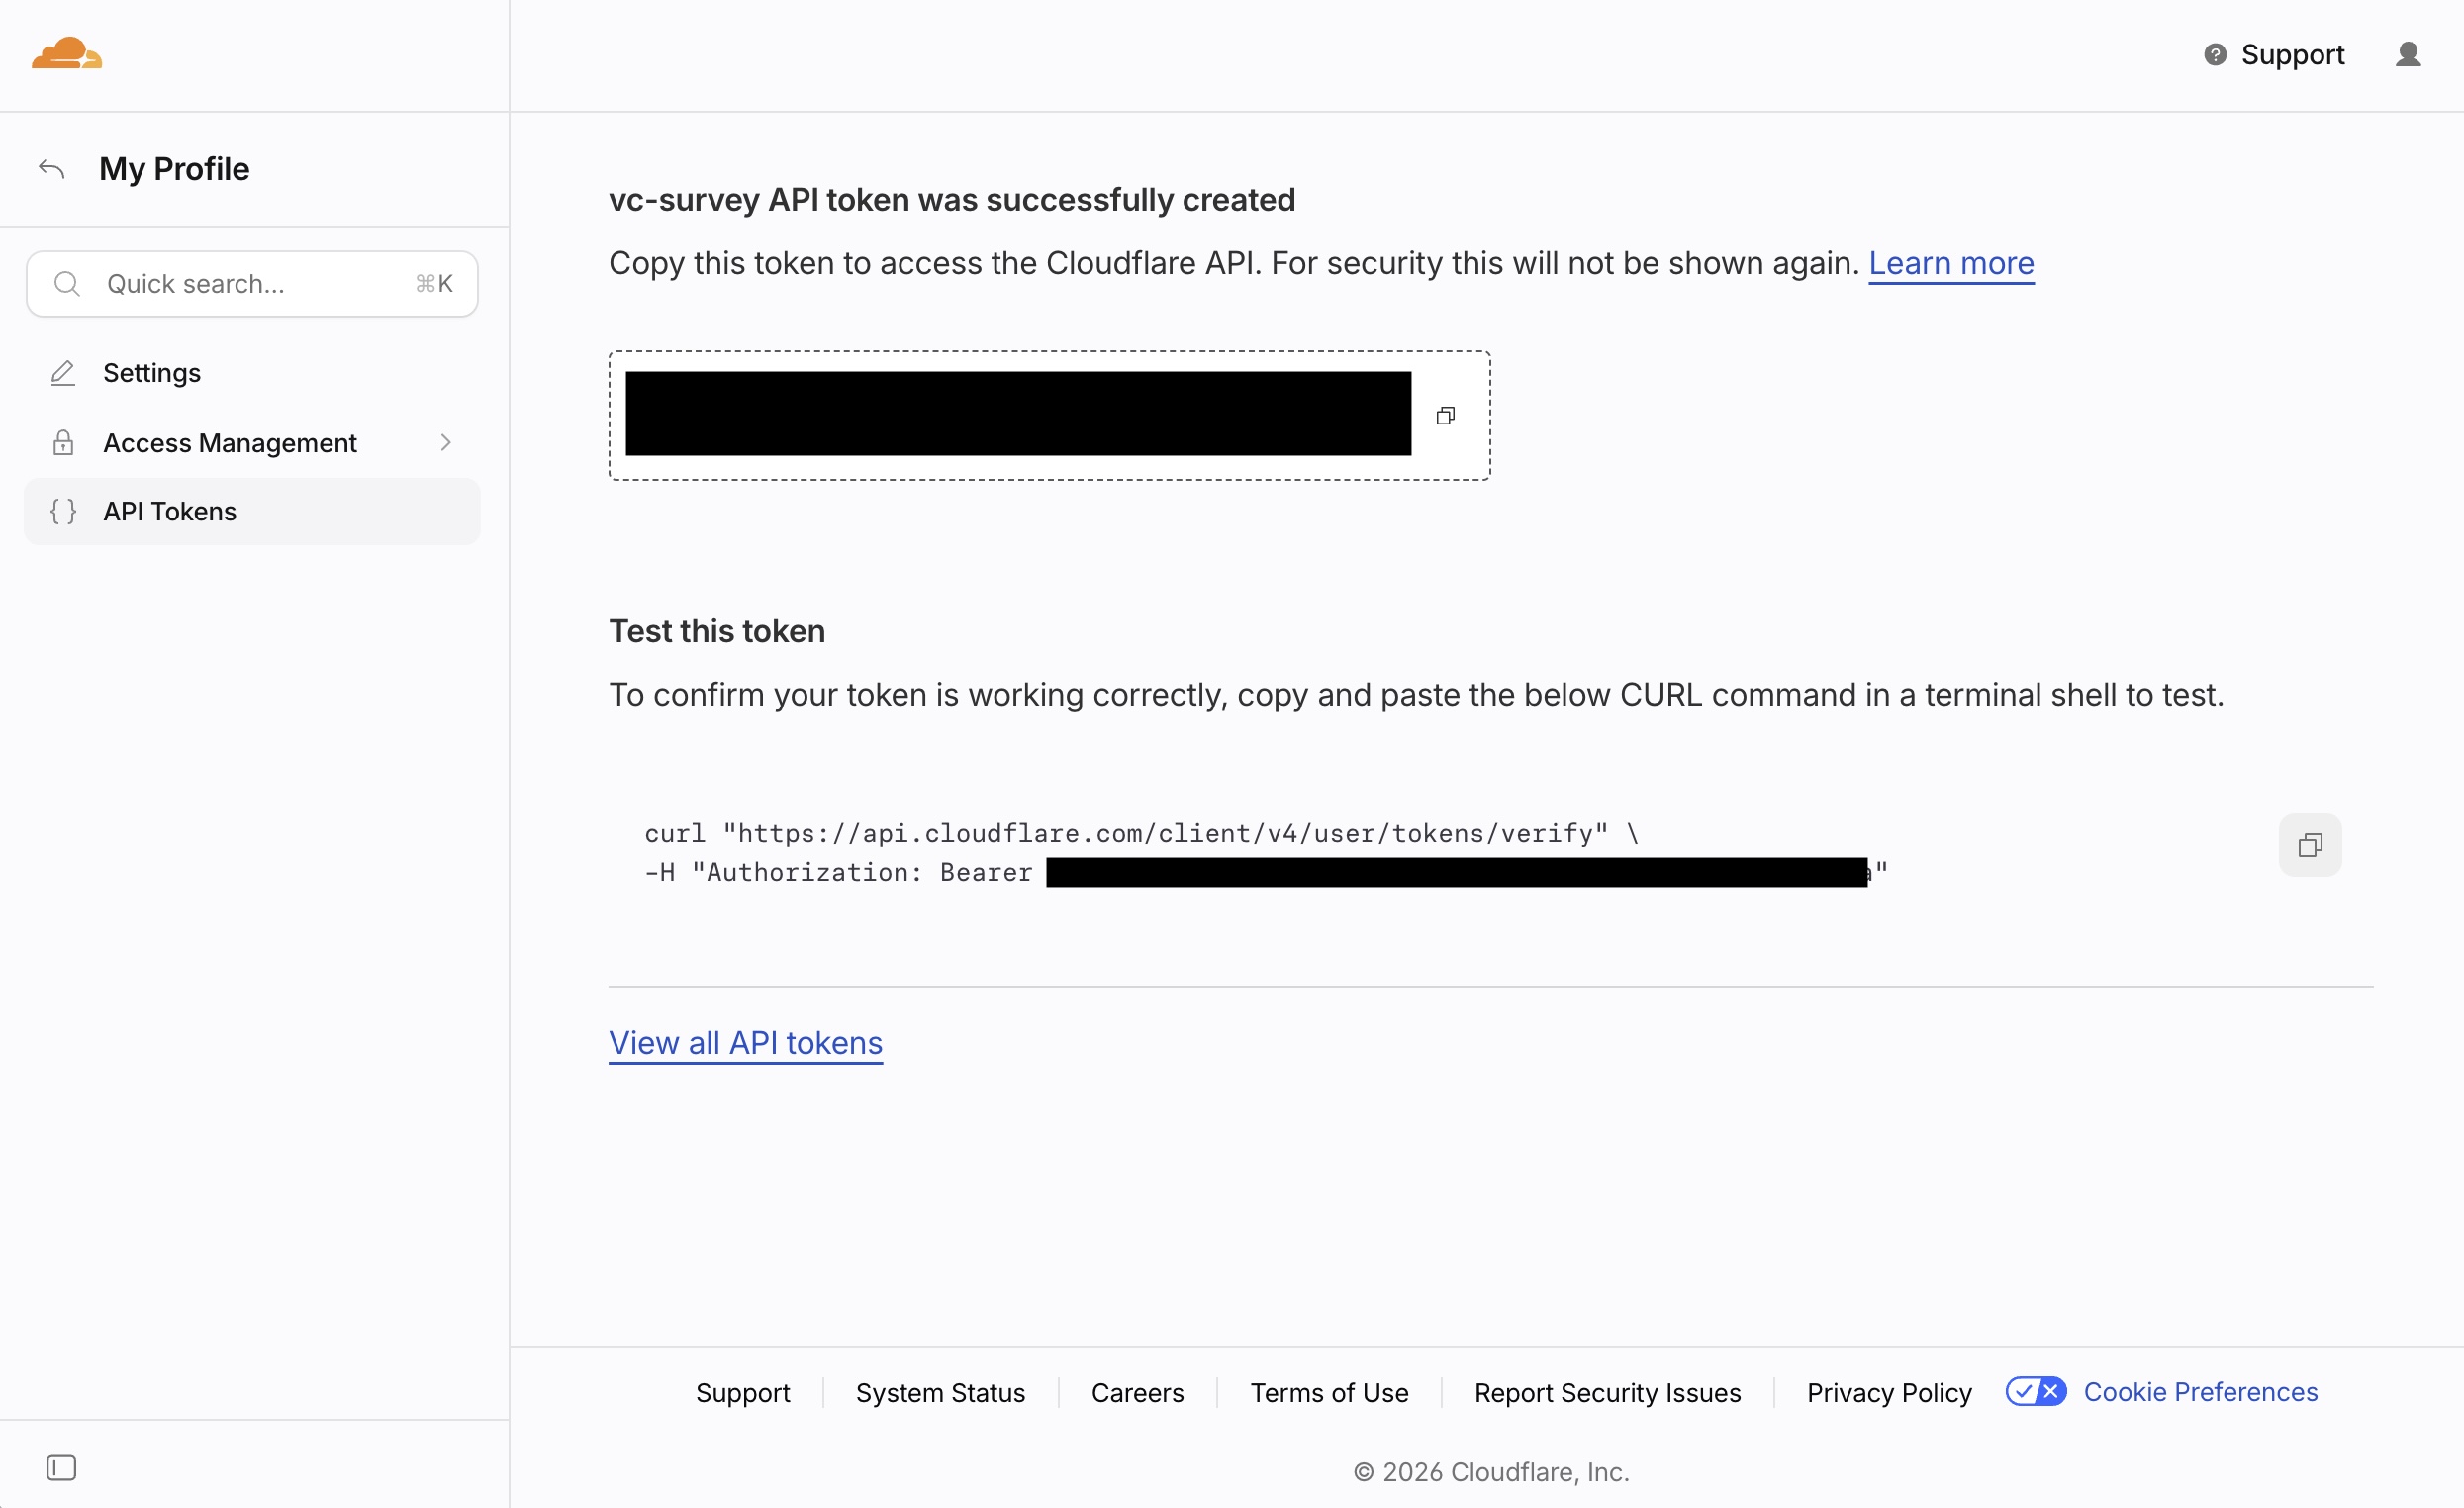
この文字列が表示されるのは、この一度きり(画面にもそう書いてある)。閉じると二度と見られないので、次の手順をこの画面のまま進める。
6-2. 秘密を預ける
Section titled “6-2. 秘密を預ける”トークンを手元のファイルに保存する方法もあるが、この記事では保存しない。Cloudflare に預けてしまう。
npx wrangler secret put CF_API_TOKEN実行するとトークンの入力を求められる。貼り付けても画面には表示されず、ターミナルの履歴にも残らない。 ファイルを作る必要もないので、「隠しファイルが Finder で見えない」「拡張子が勝手に付く」といった、本筋と関係ないところでつまずかずに済む。
この名前は、あとでプロンプトに書いて伝える。 ターミナルで登録したものは、Claude Code からは見えない(登録したことも、名前も)。6-3 で「シークレットの
CF_API_TOKENを使う」と指定しているのはそのため。指定しないと、エージェントは別の名前を前提にコードを書くか、聞き返してくる。
CF_API_TOKENは予約語ではない。 自分で決めてよい名前で、コードからenv.CF_API_TOKENとして読むだけ。ただし紛らわしいことに、wrangler 自身が認証に使う環境変数にも同じ名前がある(CF_API_TOKEN/CF_ACCOUNT_ID。いまは非推奨で、公式はCLOUDFLARE_始まり)。置き場所が違うので衝突しないが、気になるならSURVEY_API_TOKENのような名前にしてもよい(6-3 のプロンプトも合わせる)。
残り2つは Claude Code に任せる。名前まで指定するのがポイント。ここを決めずに頼むと、エージェントが自分で名前を付けてしまい、次の 6-3 と食い違う。
あと2つ、Workers のシークレットに登録して。- CF_ACCOUNT_ID … Cloudflare のアカウントID- RESULTS_KEY … 集計ページを守るためのランダムなキー(推測できない長さで生成して)アカウントIDは秘密ではない(ダッシュボードの URL にも出ている)。それでもシークレットに入れるのは、コードに直接書かないため。値そのものより、「秘密の置き場所を1か所にまとめる」ほうが目的にある。
6-3. 集計ページを作る
Section titled “6-3. 集計ページを作る”ここまでで鍵は揃ったが、集計を見る画面はまだ無い。作る。
CLAUDE.md に書いた「どの値をどこに入れたか」をもとに、集計ページを作って。アンケートと同じトップページに、キー付きで開いたときだけ出す形にする。
- ?r=<RESULTS_KEY の値> を付けて開いたときは、集計を表示する- 何も付けずに開いたときは、いつもどおりアンケート画面を出す- キーが違うときは 404 を返す(「権限がありません」とは出さない)- 集計は Analytics Engine の SQL API を Cloudflare の REST API 経由で呼び出して出す- そのときの認証には、シークレットの CF_API_TOKEN と CF_ACCOUNT_ID を使う- SURVEY_ID で絞る- 同じ回答者が何度答えていても、いちばん新しい回答だけを数える- 質問ごとに、選択肢が何票ずつかを表示する- SQL に WITH(CTE)は使わない。Analytics Engine では使えないので、サブクエリで書く
「何も付けないときは、いつもどおりアンケート」を必ず書く。 ここを落として「キーが無ければ404」とだけ頼むと、回答者が普通に開いたときまで404になる。エージェントが「トップページ自体を集計にするのか、別ページを作るのか」と聞き返してくることもある。
別ページ(
/resultsなど)にする手もある。 トップページの挙動を変えずに済む代わりに、URL が1つ増える。この記事は配る URL を1つに保ちたいのでトップページに寄せている。
WITHが使えないのは Analytics Engine の制約。 使うと 502 が返る。JOINやUNIONも使えない。エージェントは普通の SQL のつもりでWITHを書くことがあるので、先に断っておく。
できたらデプロイする。
デプロイして、集計ページの URL を教えてここで扱いを分けているのが大事なところ。 同じ「秘密」でも強さが違う。
| 何ができてしまうか | 扱い | |
|---|---|---|
| API トークン | アカウントの分析データを全部読める | 自分で入力する。 コマンドに書くと履歴に残る |
| 集計ページのキー | このアンケートの集計が見えるだけ | 自動でいい |
| アカウントID | ただの識別子。単体では何もできない | 自動でいい |
秘密を全部同じように厳重に扱おうとすると手間が増えて、結局どこかで手を抜くことになる。強いものだけを慎重に扱う方が続く。
7. 結果を見る
Section titled “7. 結果を見る”6-3 で作った集計ページは、URL に推測できないキーを付けて守っている。RESULTS_KEY に入れた値がそのキー。
https://my-survey.<アカウントのサブドメイン>.workers.dev/?r=<キー>キーが違えば 404 を返す。「権限がありません」ではなく「そんなページはない」と答えることで、ページの存在自体を隠している。
Claude Code から見ることもできる。
アンケートの集計結果を見せて7-1. 重複回答をどう消しているか
Section titled “7-1. 重複回答をどう消しているか”集計するときに、回答者ごとにまとめて、いちばん新しい回答だけを取り出してから数えている。SQL にはそのための書き方があるので、ひとつのクエリでよい。
同じ人が答え直しても、票は増えずに移動するだけになる。書き込むときには何の判定もしていないのに、これが成り立つ。
数える前にアンケートIDで絞っているのも大事なところ。この表には過去のアンケートも入っているので、絞らないと混ざる。
8. 締切を設ける
Section titled “8. 締切を設ける”アンケートには回答期間がある。締切を1つ決めるだけで、3つのことが同時に決まる。
アンケートに締切をつけて。2026年8月20日の23時59分まで受け付ける。
- 締切を過ぎたら回答を受け付けない- 回答者を見分ける cookie も、締切と同時に切れるようにする- 締切後に開いた人にはフォームを出さず、終了したことを伝える
設定ファイルにはこんな形で足される。
"vars": { "SURVEY_CLOSES_AT": "2026-08-20T23:59:59+09:00" }これで決まるのが次の3つ。
- この時刻を過ぎたら回答を受け付けない
- 回答者を見分ける cookie も、この時刻に切れる
- 締切後に開いた人にはフォームを出さない
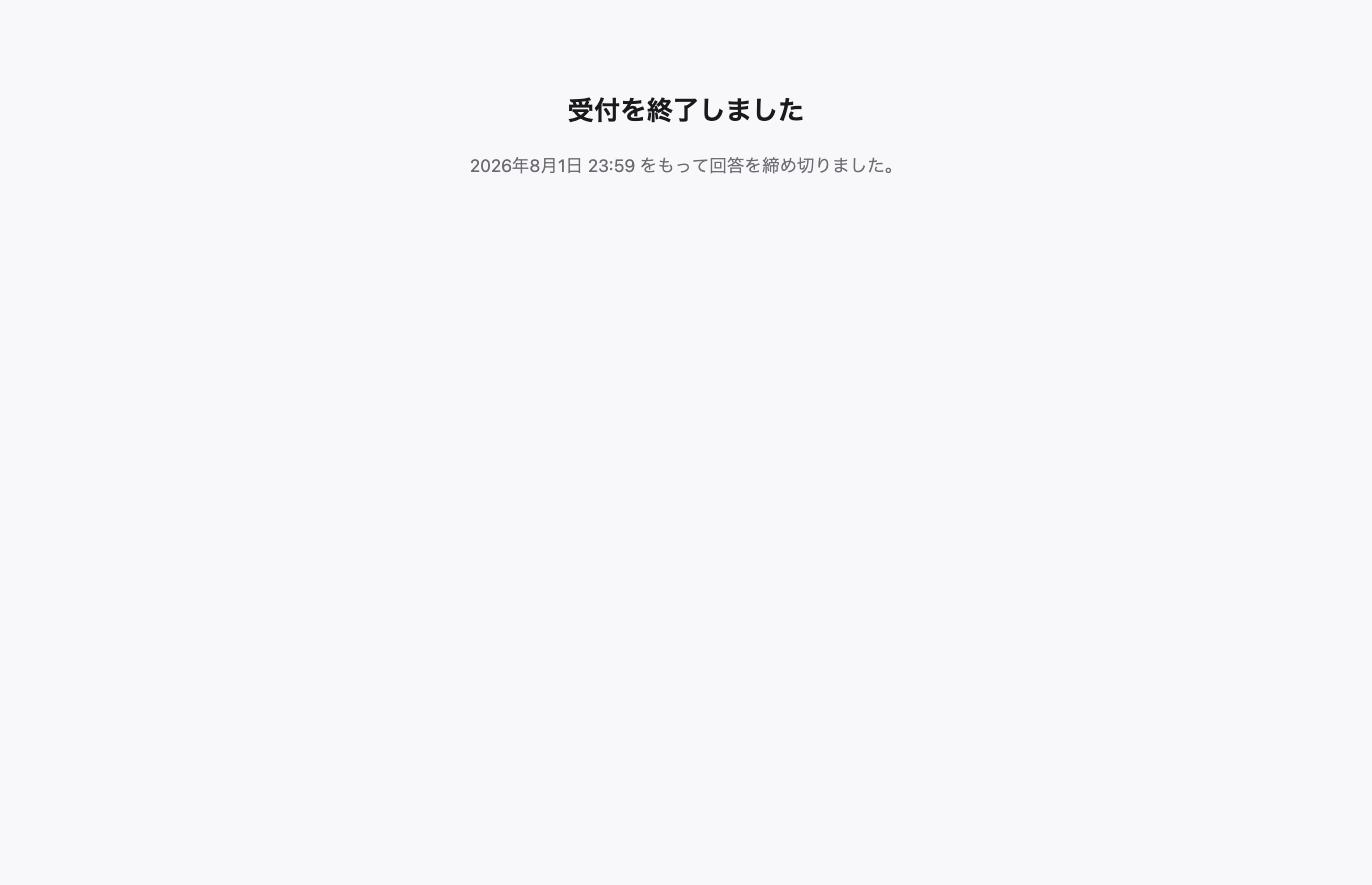
2つ目は見落としやすい。cookie の期限に締切をそのまま入れているので、次に別のアンケートを取るとき、前回の回答者と結びつかない。「N日空けてから次をやる」というルールを人が覚えておく必要がなくなる。
cookie の期限は、秒数で指定する Max-Age と、日時で指定する Expires の2つがある。締切があるなら Expires の方が素直。両方書くと Max-Age が優先されるので、片方だけにする。
9. 診断機能を足す
Section titled “9. 診断機能を足す”答え終わった人に、回答を元に何かしらの診断・判定結果を返す。
やることは、選択肢に点数を持たせて、合計で区分を決めるだけ。
アンケートに診断をつけて。
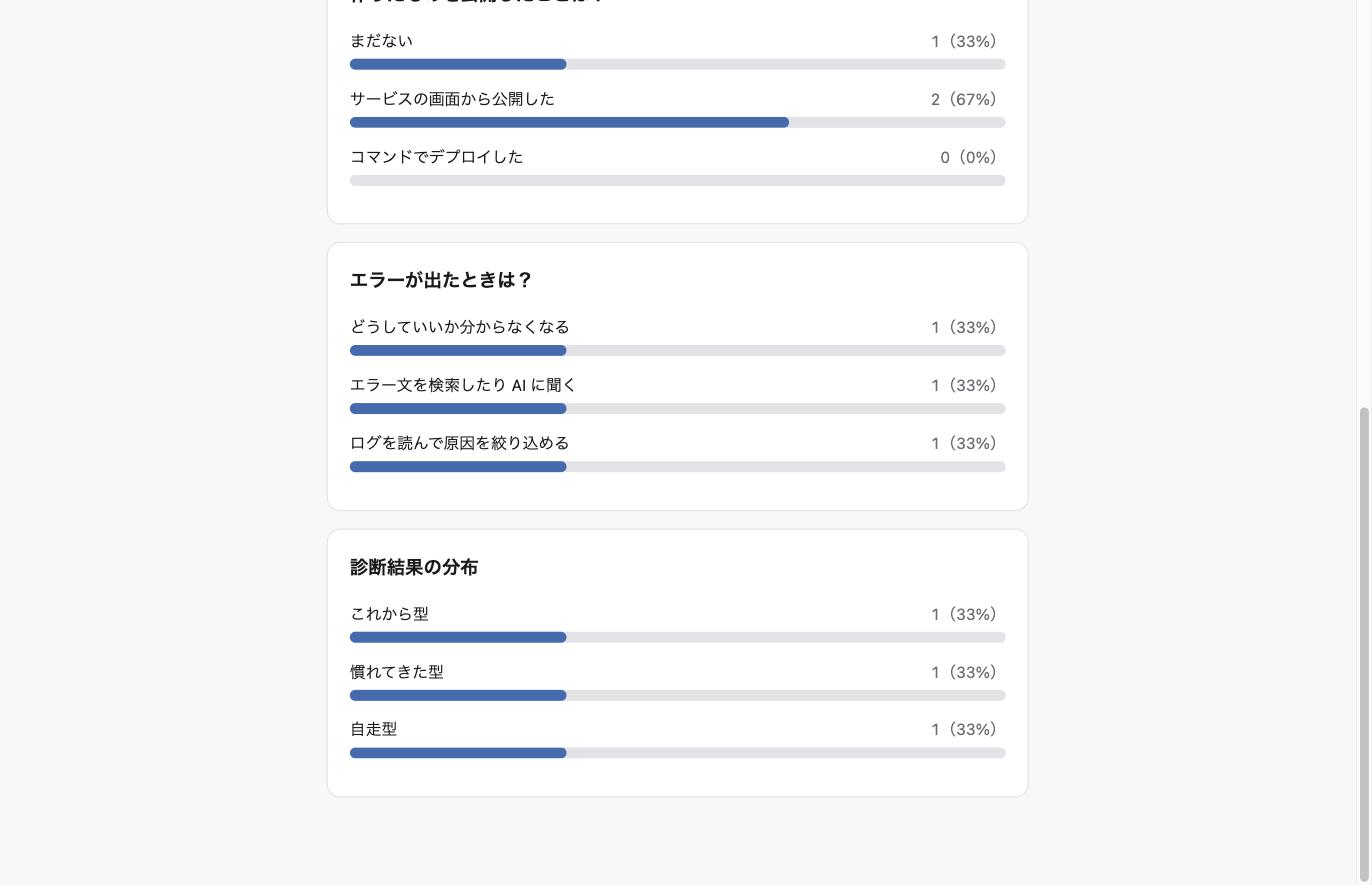
- 選択肢ごとに点数を持たせて、合計点で3つの区分に分ける- 0〜2点は「これから型」、3〜5点は「慣れてきた型」、6〜8点は「自走型」- 答え終わった画面に、区分の名前と説明を出す- 診断結果も回答のひとつとして一緒に送って、集計に出るようにする質問データに点数が足され、区分の定義が加わる。今回は4問それぞれ最大2点なので満点は8点。0点以上・3点以上・6点以上の3段階を決めておき、届いた中でいちばん高い区分が選ばれる。
区分の名前は否定的にしない方がいい。 正直に「初心者」と出すこともできるが、答えた人がそれを見てどう感じるかを考えると、「これから型」の方がいい。診断は数を集めるためのものでもあるので、答えて損した気分にさせない。
プロンプトの最後に書いた1行がこれ。診断結果を、回答のひとつとして一緒に送っている。 質問が1つ増えたのと同じ扱いになるので、集計側は何も変えていないのに、集計ページに「診断結果の分布」が並ぶ。
9-1. この構成が要るのはどんなときか
Section titled “9-1. この構成が要るのはどんなときか”この章で足したものは、全部 public/index.html の中にある。 サーバー側の src/index.js は1行も変えていない。診断はイベントログを使っていないので、ファイルをダブルクリックして開くだけでも動く(送信されないだけ)。
つまり診断だけなら、この記事で作ってきた仕組みは要らない。
逆に「アンケートなら Google フォームでいいのでは」とも思うかもしれない。集めるだけなら、そのとおり。 ただ診断を入れると事情が変わる。
| Google フォーム | この記事の構成 | |
|---|---|---|
| 回答後のメッセージ | 1つだけ。 回答に応じて出し分けることはできない | 点数に応じて出し分けられる |
| 回答による分岐 | あるが1問の回答による分岐。3問3択なら27通りのセクションを手で作ることになる | 質問が増えても点数を足すだけ |
| テスト機能のフィードバック | 設問ごとの解説であって、合計点に応じた出し分けではない | 合計点で区分を決める |
分岐機能はあるが、分岐は「木」であって「集計」ではない。「点数を足して閾値で判定する」という診断のやり方は、分岐では表現できない。組み合わせを全部展開することになって、質問が増えると破綻する。
Apps Script を使えば判定はできる。ただし動くのは送信後のサーバー側なので、メールを送るか別のページに飛ばすかしかできない。「送信した瞬間に画面に出る」体験は作れない。
整理するとこうなる。
| やりたいこと | 必要なもの |
|---|---|
| 回答を集めるだけ | Google フォームで足りる |
| 診断を返すだけ | HTML を1枚公開するだけ(HTMLをアップロードして公開するの範囲) |
| 集めて、かつ返す | この記事の構成 |
上の2つのどちらかなら、今回の構成でなくていい。 イベントログも Worker も出番がない。
10. ここから先
Section titled “10. ここから先”10-1. 自由記述を足したいとき
Section titled “10-1. 自由記述を足したいとき”選択式ではなく自由に書いてもらうこともできる。POST で送っているので URL の長さは関係なく、1問あたり日本語で5000文字ほどまで入る。ただし考えることが増える。
- 集計の形が変わる。 数えられないので一覧を出すことになる
- 画面に出すときのエスケープが必要になる。 選択肢IDは英数字だけだったので危険がなかったが、自由記述は何でも入る
- 匿名でなくなることがある。 名前や所属を書いてしまう人がいる。仕組みでは防げないので、設問文で断るしかない
自由記述が主役になるなら、素直に Google フォームを使うか、D1 を使う方がいい。今回の構成は「数えるもの」に向いている。
10-2. この構成が向かないもの
Section titled “10-2. この構成が向かないもの”- その場で結果を見せたい。 集計への反映に数十秒かかる
- 厳密な一人一票。 シークレットウィンドウや別のブラウザを使えば別人になる
- 長く残したい。 Analytics Engine のデータは3か月で消える
3つ目が引っかかるなら、D1でデータ共有型Webアプリを作るに進む。データベースが必要になる場面が、自分の手で体験した後だと分かりやすくなっているはず。
10-3. もう一度アンケートを取るとき
Section titled “10-3. もう一度アンケートを取るとき”survey.md を書き換えて、wrangler.jsonc の SURVEY_ID と締切を新しくするだけ。 あとは作り直してデプロイすれば、次のアンケートが始まる。
survey.md を書き換えたので、アンケートのページを作り直して前の質問を残しておきたいなら、survey-2026-08.md のように名前を付けて取っておく。集計は過去のぶんも残っているので、あとから見比べられる。
"vars": { "SURVEY_ID": "menu-2026-11", "SURVEY_CLOSES_AT": "2026-11-30T23:59:59+09:00"}ベース名も dataset も変えなくていい。 Worker もデータセットもそのまま使い回す。Analytics Engine のデータは消せないが、回答にアンケートIDが入っているので、集計のときに今回の分だけを取り出せる。
変えるのは SURVEY_ID と締切の2つだけ、と覚えておく。
締切をまたげば cookie も切れているので、前回の回答者とは結びつかない。
過去のアンケートの集計も残っている。URL にIDを足せば見られる。
https://my-survey.<アカウントのサブドメイン>.workers.dev/?r=<キー>&s=level-2026-0810-4. 複数のサイトで1つのデータセットを使う
Section titled “10-4. 複数のサイトで1つのデータセットを使う”別のサイト(別の Worker)から、同じデータセットに書き込むこともできる。 wrangler.jsonc の dataset に同じ名前を書くだけ。データセットはアカウント側にある表で、binding はそれを呼ぶプロジェクト内の名前なので、名前を合わせれば同じ表に集まる。
集計の仕組みを1つにまとめられるのが利点。データセットをいくつ作っても構わない(数の上限は書かれていない)ので、必ずしもまとめる必要はないが、「どのサイトの分も同じ画面で見たい」なら1つにする手がある。
まとめるなら、IDの付け方に規則が要る。
siteA-level-2026-08siteB-menu-2026-11SURVEY_ID にサイト名を含めておけば、集計のときに絞れる。絞り忘れると他のサイトの回答が混ざるので、そこだけ注意する。
indexesの集中には気をつける。 間引きは index の値ごとに起きる(→ 1-1)。サイトが増えて同じ値に書き込みが集まると、間引かれやすくなる。IDにサイト名を含めておけば、ここも自然に散る。
見る人を分けたいなら、データセットを分けても意味がない。 API トークンの権限は
Account Analytics: Readなので、トークンを持つ人はアカウント内のどのデータセットも読める。サイトごとに見る人が違うなら、集計ページの側(RESULTS_KEY)で分けることになる。
2026-08-11 (last updated: 2026-09-18)  タツヲ (yto)